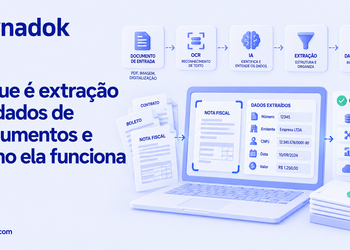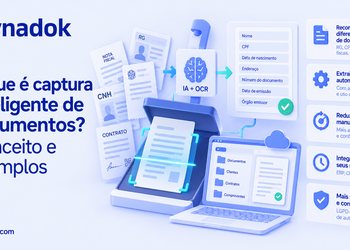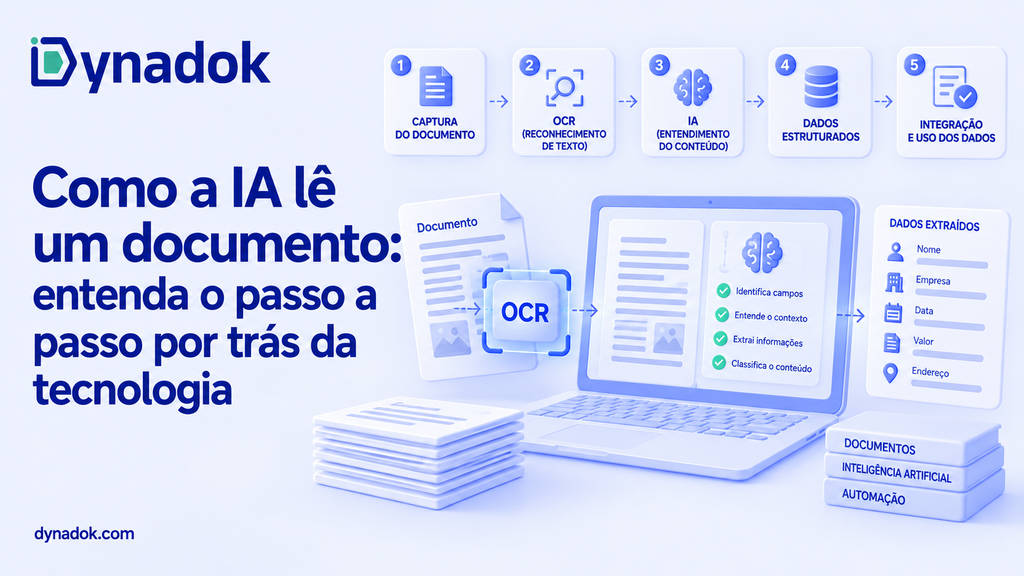
A IA não lê um documento como uma pessoa. Ela converte a página em pixels e coordenadas, reconhece caracteres, interpreta a estrutura visual, classifica o tipo documental, extrai os campos com modelos de linguagem, atribui um grau de confiança a cada valor e cruza o resultado com regras e outras fontes. O que chega ao analista é a exceção, não o documento inteiro.
Prompt copiado! É só colar no Gemini.
Pontos-chave
- O termo técnico é IDP, Intelligent Document Processing: segundo a AIIM e a Deep Analysis, é o software que usa IA para permitir que um computador leia documentos e extraia dados deles, substituindo os antigos produtos de captura e OCR.
- 78% das empresas pesquisadas já estão operacionais com IA no processamento de documentos, em levantamento com 600 organizações dos Estados Unidos, Alemanha, Áustria e Suíça.
- A média de automação é de 63% dos documentos, o que significa que mais de um terço ainda passa por conferência humana.
- Precisão não é um número único: o relatório da AIIM e da Deep Analysis decompõe o conceito em nível de caractere, de palavra e de campo, limiares, classificação, contexto, validação contra fonte de verdade e tratamento de exceções.
- Reduzir headcount é a menor medida de sucesso apontada pelas empresas, com 30%, contra 50% que medem sucesso pela redução do tempo de processamento.
- O art. 20 da LGPD garante ao titular o direito de solicitar revisão de decisões tomadas unicamente com base em tratamento automatizado que afetem seus interesses.
- Papel não acabou: 61% dos processos de IDP ainda incluem documentos em papel, e apenas 1% das empresas acreditava que estaria sem papel em 2026.
O que significa dizer que a IA “lê” um documento?
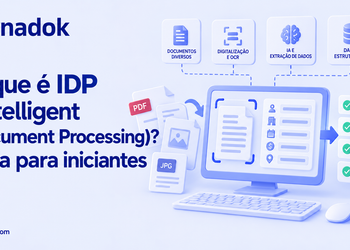
Ler, aqui, é um atalho de linguagem. O que a tecnologia faz é transformar uma imagem ou um arquivo em dados estruturados que um sistema consegue usar. A AIIM e a Deep Analysis definem a categoria com precisão: software de IDP usa inteligência artificial para permitir que um computador leia documentos e extraia dados deles, substituindo softwares mais antigos de captura de documentos ou de OCR.
A diferença em relação a um ser humano é onde está a dificuldade. Uma pessoa olha um holerite e entende o documento antes de ler cada campo. A máquina faz o caminho inverso: parte do pixel, monta caracteres, monta palavras, entende onde elas estão na página e só então descobre que aquilo é um holerite. Cada uma dessas etapas pode falhar, e é por isso que a arquitetura importa mais que o modelo isolado.
Qual a diferença entre OCR e IDP?
Quanto a validação manual custa para a sua empresa hoje?
Ajuste 3 dados da sua operação e veja, na hora, quanto a conferência manual consome do seu caixa — e quanto volta para ele com a validação de documentos com IA.
de volta ao seu caixa — R$ 43.867 por mês
Cenário-exemplo: 20 mil páginas/mês, 5 min por página. Faça a conta com os números da sua operação.OCR é reconhecimento óptico de caracteres: ele converte a imagem de um texto em texto pesquisável. É uma etapa, não uma solução. O OCR entrega uma sequência de caracteres, mas não sabe qual deles é o CPF, se a data está vencida ou se o valor bate com o contrato.
IDP é a camada que dá sentido a esse texto. Ela classifica o documento, localiza campos, interpreta o conteúdo e aplica regras de negócio. O relatório da AIIM e da Deep Analysis registra que os modelos de machine learning são usados em produtos de IDP desde meados dos anos 2000 e que ferramentas de visão computacional foram amplamente adotadas desde o início dos anos 2010. A IA generativa é a camada mais recente, não a primeira.
Como a IA lê um documento passo a passo?
O caminho é sempre o mesmo, mude o fornecedor ou o modelo. As oito etapas abaixo descrevem o ciclo completo, da chegada do arquivo até o dado gravado no sistema.
- Captura e ingestão. O arquivo chega por upload, e-mail, API ou digitalização. A origem importa: 61% dos processos de IDP ainda incluem papel, segundo a AIIM e a Deep Analysis, e o documento escaneado entra no fluxo com qualidade e regime jurídico diferentes do arquivo nato-digital.
- Pré-processamento da imagem. Antes de reconhecer qualquer caractere, o sistema corrige inclinação, remove ruído, ajusta contraste, detecta e separa páginas. Uma foto tremida ou um scan torto derruba a qualidade de tudo o que vem depois, e nenhum modelo recupera informação que não foi capturada.
- Extração da camada de texto ou OCR. Se o PDF já tem texto embutido, o sistema o lê diretamente. Se é imagem, entra o OCR, e a variante para manuscrito, chamada HTR. Aqui vale um alerta técnico: o ITI registra que o formato PDF admite inserção de objetos gráficos em camadas, alterando o visual do conteúdo, o que significa que o que se vê e o que está no arquivo nem sempre coincidem.
- Análise de layout. O sistema reconstrói a geometria da página: blocos de texto, tabelas, cabeçalhos, rodapés, carimbos, campos de formulário. Cada palavra ganha coordenadas. É essa etapa que permite entender que o número à direita do rótulo “Valor líquido” pertence àquele rótulo, e não ao de baixo.
- Classificação do documento. Com texto e layout em mãos, o modelo decide qual é o tipo documental: contrato, holerite, ASO, nota fiscal, comprovante de endereço. A classificação define qual checklist será aplicado, e um erro aqui contamina tudo o que vem depois, porque o sistema passa a procurar campos que não existem.
- Extração dos campos. Modelos de linguagem localizam e devolvem os valores pedidos. A vantagem sobre o gabarito fixo é a tolerância a layout novo: o modelo entende que “Remuneração bruta” e “Salário bruto” cumprem a mesma função, mesmo em documentos que nunca viu.
- Validação, confiança e regras de negócio. Cada valor extraído recebe um grau de confiança. O sistema confere a aritmética interna, aplica as regras do processo, checa vigência e cruza campos entre documentos. Quando o documento tem assinatura digital, entra também a validação automática de assinaturas e certificados ICP-Brasil.
- Decisão, exceção e trilha. Acima do limiar definido, o documento segue direto. Abaixo, vai para revisão humana. Em todos os casos, fica registrado o que foi lido, com qual confiança, qual regra foi aplicada e qual foi o resultado. Essa trilha é o que sustenta auditoria e defesa depois, e ganha uma âncora temporal auditável quando o fluxo aplica o carimbo do tempo emitido por uma Autoridade de Carimbo do Tempo credenciada.
Por que o gabarito e o OCR puro deixaram de dar conta?
Porque o gabarito pressupõe que o documento sempre chega igual, e ele não chega. Um modelo baseado em posição fixa quebra quando a concessionária muda o layout da fatura, quando o holerite vem de outro sistema de folha ou quando o fornecedor manda a foto em vez do PDF. Cada variação vira um projeto de manutenção.
O mercado se moveu por causa disso. Segundo a AIIM e a Deep Analysis, 65% das empresas pesquisadas têm ou consideram um novo projeto de IDP e, desse grupo, 66% pretendem substituir um sistema existente. O relatório atribui a disrupção aos LLMs e registra que, desde 2017, ano em que o Google introduziu o método transformer que está por trás desses modelos, mais de 100 startups entraram no mercado de IDP.
A razão técnica é simples de enunciar. O gabarito sabe onde olhar; o modelo de linguagem entende o que está lendo. Um sistema que entende contexto lida com layout novo sem treino específico, processa documento não estruturado e reconhece manuscrito, três coisas que templates e OCR isolado nunca resolveram bem.
Quanto disso já é realidade nas empresas?
Bastante, e mais rápido do que o discurso de ceticismo sugeria. A pesquisa Market Momentum Index, conduzida pela Deep Analysis em parceria com a AIIM e patrocinada pela DocuWare, ouviu 600 empresas dos Estados Unidos, Alemanha, Áustria e Suíça, todas com receita acima de US$ 10 milhões e mais de 500 funcionários, entre 6 e 21 de maio de 2025.
| Indicador | Número | Período | Fonte |
|---|---|---|---|
| Empresas operacionais com IA no processamento de documentos | 78% | 2025 | AIIM e Deep Analysis |
| Empresas com projeto de IDP novo ou em consideração | 65% | 2025 | AIIM e Deep Analysis |
| Projetos novos que substituem um sistema existente | 66% | 2025 | AIIM e Deep Analysis |
| Média de documentos já processados de forma automatizada | 63% | 2025 | AIIM e Deep Analysis |
| Processos de IDP que ainda incluem papel | 61% | 2025 | AIIM e Deep Analysis |
| Sistemas de IDP que envolvem usuários externos | 62% | 2025 | AIIM e Deep Analysis |
| Empresas que medem sucesso por redução de headcount | 30% | 2025 | AIIM e Deep Analysis |
| Documentos falsificados gerados por inteligência artificial | 1 em cada 50 | 2025 | Sumsub |
Fonte: elaboração própria com base no Market Momentum Index: IDP Survey 2025, da AIIM e da Deep Analysis, e no Identity Fraud Report 2025-2026 da Sumsub.
Dois números merecem leitura conjunta. A automação média está em 63% dos documentos, e apenas 30% das empresas apontam redução de headcount como medida de sucesso, contra 50% que medem pela redução do tempo de processamento. O próprio relatório é direto ao concluir que a IA de IDP não vai substituir humanos e que a maior parte dos casos de uso envolve humano no circuito.
O que a lei exige de quem automatiza a leitura de documentos?
Ler documento com IA quase sempre significa tratar dado pessoal, e isso ativa a LGPD por inteiro. O dispositivo mais direto é o art. 20: “O titular dos dados tem direito a solicitar a revisão de decisões tomadas unicamente com base em tratamento automatizado de dados pessoais que afetem seus interesses, incluídas as decisões destinadas a definir o seu perfil pessoal, profissional, de consumo e de crédito ou os aspectos de sua personalidade”.
O § 1º do mesmo artigo acrescenta o dever de explicar. O controlador deve fornecer, sempre que solicitadas, informações claras e adequadas a respeito dos critérios e dos procedimentos utilizados para a decisão automatizada, observados os segredos comercial e industrial. Na prática, isso torna a trilha de auditoria do passo 8 uma exigência legal, não uma boa prática opcional.
| Norma | O que exige | Quem responde |
|---|---|---|
| LGPD, art. 6º, III | Limitar o tratamento ao mínimo necessário para a finalidade | Controlador |
| LGPD, art. 6º, X | Demonstrar a adoção de medidas eficazes e comprovar o cumprimento da lei | Controlador |
| LGPD, art. 11, II, “g” | Admite tratar dado sensível para prevenção à fraude na identificação e autenticação de cadastro | Controlador |
| LGPD, art. 20 | Garantir ao titular o direito de pedir revisão de decisão automatizada | Controlador |
| LGPD, art. 20, § 1º | Informar critérios e procedimentos da decisão automatizada quando solicitado | Controlador |
| LGPD, art. 46 e § 2º | Adotar medidas de segurança desde a concepção do produto até a execução | Controlador e operador |
| Circular BCB nº 3.978/2020, art. 40 | Manter documentação de parâmetros, variáveis, regras e cenários dos sistemas | Instituição autorizada pelo BCB |
| Circular BCB nº 3.978/2020, art. 67, I | Conservar as informações de conhecer o cliente por no mínimo dez anos | Instituição autorizada pelo BCB |
Fonte: elaboração própria com base na Lei nº 13.709/2018 (LGPD) e na Circular BCB nº 3.978/2020.
Vale destacar a coerência entre as duas normas. O art. 40 da Circular BCB nº 3.978/2020 exige documentar parâmetros, variáveis, regras e cenários dos sistemas e determina que eles sejam passíveis de verificação quanto à adequação e à efetividade. É a mesma lógica do art. 20 da LGPD, aplicada ao supervisor em vez do titular: quem automatiza precisa conseguir explicar.
Onde a leitura automática ainda falha?
Falha, e conhecer os limites é o que separa um projeto que entrega de um piloto que decepciona. Os pontos de atrito recorrentes são:
- Qualidade de captura ruim. Foto tremida, scan cortado, documento amassado e sombra sobre o texto derrubam o OCR na origem. Nenhuma etapa posterior recupera informação que não foi capturada.
- O que se vê não é o que está no arquivo. O ITI registra que o PDF admite inserção de objetos gráficos em camadas, alterando o visual do conteúdo. Um valor pode estar visualmente coberto por outro, e a leitura precisa olhar a estrutura, não só a renderização.
- Documento autêntico com conteúdo falso. A verificação de layout e a extração não dizem se o valor declarado é verdadeiro. A checagem visual, aliás, está entre as camadas mais expostas, segundo a Sumsub, porque 1 em cada 50 documentos falsificados já é gerado por IA.
- Classificação errada em documento híbrido. Um arquivo com contrato, procuração e comprovante no mesmo PDF exige separação correta antes da extração, e é aí que muitos fluxos tropeçam.
- Ausência de fonte de verdade para cruzar. O relatório da AIIM e da Deep Analysis lista a validação contra uma fonte de verdade como um dos componentes da precisão. Sem base para comparar, o sistema confirma coerência interna, não veracidade.
- Exceção sem dono. Quando o documento cai abaixo do limiar e não há fila de revisão definida, a automação vira gargalo em vez de ganho.
Como resume Leandro Bartolassi, Diretor de Autenticação e Prevenção a Fraude da Serasa Experian, “não existe uma única tecnologia capaz de interromper todos os tipos de fraude”. Vale para leitura de documentos: a resposta é camada, não bala de prata.
Como escolher entre OCR, gabarito e IDP com IA?
A escolha depende de quanto os documentos variam e de quanto o conteúdo precisa ser interpretado, não apenas transcrito.
| Critério | OCR puro | Gabarito por posição | IDP com IA |
|---|---|---|---|
| O que entrega | Texto pesquisável | Campos em posições fixas | Campos interpretados no contexto |
| Layout novo sem treino | Não se aplica | Quebra | Tolera |
| Documento manuscrito | Limitado | Não | Sim, com HTR |
| Classifica o tipo documental | Não | Não | Sim |
| Grau de confiança por campo | Não | Raramente | Sim |
| Quando usar | Tornar acervo pesquisável | Formulário próprio e estável | Documentos de terceiros, variados e em volume |
Fonte: elaboração própria com base na definição de IDP e nos componentes de precisão descritos pela AIIM e pela Deep Analysis.
Quais erros de implantação comprometem o resultado?
Os erros mais caros aparecem antes do modelo, no desenho do processo. Os recorrentes são:
- Tratar precisão como número único. A AIIM e a Deep Analysis alertam que a alegação de “99,5% de acurácia” é simplista e que precisão envolve nível de caractere, de palavra e de campo, limiares, classificação, contexto e validação contra fonte de verdade. A consequência de comprar o número é frustração na primeira semana.
- Automatizar o processo errado. Digitalizar um fluxo desenhado para papel só acelera o desperdício. O relatório aponta que a falta de habilidade em redesenho de processo está entre as capacidades internas que faltam nas empresas.
- Não definir limiar nem fila de exceção. Sem regra clara de quando o documento passa direto e quando vai para o humano, a operação alterna entre aprovar demais e revisar tudo.
- Ignorar segurança e privacidade no desenho. É a preocupação número 1 apontada pelas empresas pesquisadas, e o art. 46, § 2º, da LGPD exige medidas de segurança desde a concepção do produto até a execução. A consequência de deixar para depois é retrabalho de arquitetura.
- Não guardar a trilha da decisão. Sem registro do que foi lido, com qual confiança e sob qual regra, a empresa não consegue atender ao art. 20, § 1º, da LGPD nem demonstrar diligência em auditoria.
- Medir sucesso só por corte de pessoal. Apenas 30% das empresas usam redução de headcount como métrica, contra 50% que medem redução do tempo de processamento. Escolher a métrica errada leva a decisões erradas sobre o projeto.
Como a Dynadok lê e valida documentos?
A Dynadok percorre esse ciclo em um fluxo único. A plataforma identifica documentos estruturados, semiestruturados, não estruturados e escritos à mão, combinando diferentes modelos de IA, LLMs, OCR, visão computacional e RAG, segundo a descrição técnica da própria empresa. Depois de extrair os dados, aplica checklists configuráveis por tipo documental, cruza informações entre documentos e com os sistemas do cliente, e notifica não conformidades em segundos, inclusive quando o envio é feito por terceiros.
Os resultados declarados pela Dynadok incluem redução de até 95% do tempo gasto com validação e análises até 10 vezes mais rápidas que a conferência manual. Segundo Cássio Lapertosa, Diretor de TI da Emccamp, a tecnologia “não só lê campos, mas interpreta documentos cruzando informações, se assemelhando à análise humana”. A implantação, segundo a Dynadok, leva de 1 a 4 meses conforme a complexidade das regras, dos tipos de documento e das integrações.
Perguntas frequentes sobre leitura de documentos com IA
O que é IDP?
IDP é a sigla de Intelligent Document Processing. Segundo a AIIM e a Deep Analysis, é o software que usa inteligência artificial para permitir que um computador leia documentos e extraia dados deles, substituindo produtos mais antigos de captura documental e de OCR. Pode ser um produto autônomo ou parte de uma solução maior.
A IA lê documento manuscrito?
Sim, com limites. A tecnologia específica se chama HTR, reconhecimento de escrita manuscrita, e funciona melhor em campos curtos e previsíveis do que em texto corrido. A qualidade da captura pesa mais aqui do que em texto impresso, e o grau de confiança tende a ser menor.
Qual a diferença entre OCR e leitura com IA?
O OCR converte a imagem em texto e para por aí. A leitura com IA acrescenta análise de layout, classificação do tipo documental, extração de campos com interpretação de contexto, grau de confiança por campo e aplicação de regras de negócio. O OCR é uma etapa dentro de um fluxo maior.
O que é grau de confiança na extração?
É a estimativa que o sistema atribui a cada valor extraído, indicando o quanto ele considera aquele resultado confiável. É esse número que alimenta o limiar: acima dele, o documento segue direto; abaixo, vai para revisão humana. Sem limiar definido, o fluxo perde o critério de exceção.
Por que a IA erra na leitura de um documento?
Os motivos mais comuns são qualidade de captura ruim, layout inédito com rótulos ambíguos, classificação errada do tipo documental e ausência de fonte externa para cruzar o dado. Erros de captura são os mais difíceis de recuperar, porque nenhuma etapa posterior devolve informação que não foi lida.
A leitura automática substitui o analista?
Não. O relatório da AIIM e da Deep Analysis é explícito ao afirmar que a IA de IDP não vai substituir humanos e que a maior parte dos casos de uso envolve humano no circuito. Reduzir headcount é a menor medida de sucesso apontada pelas empresas, com 30%.
Quanto das empresas já usa IA para ler documentos?
Na pesquisa da AIIM e da Deep Analysis com 600 empresas dos Estados Unidos, Alemanha, Áustria e Suíça, 78% se declararam operacionais com IA no processamento de documentos em 2025. A média de automação relatada é de 63% dos documentos, o que deixa mais de um terço em conferência humana.
O que a LGPD exige de um sistema que lê documentos?
Entre outros deveres, limitar o tratamento ao mínimo necessário (art. 6º, III), adotar medidas de segurança desde a concepção (art. 46, § 2º), garantir ao titular o direito de pedir revisão de decisão automatizada (art. 20) e informar critérios e procedimentos dessa decisão quando solicitado (art. 20, § 1º).
O titular pode contestar uma decisão tomada pela IA?
Sim. O art. 20 da LGPD garante ao titular o direito de solicitar revisão de decisões tomadas unicamente com base em tratamento automatizado que afetem seus interesses, incluídas as que definem perfil pessoal, profissional, de consumo e de crédito. O controlador deve explicar os critérios usados.
A empresa precisa explicar como o modelo decidiu?
Precisa informar critérios e procedimentos da decisão automatizada, nos termos do art. 20, § 1º, da LGPD, observados os segredos comercial e industrial. O § 2º prevê que, se a empresa negar as informações com base em segredo comercial, a autoridade nacional poderá auditar para verificar aspectos discriminatórios.
A IA consegue detectar documento adulterado?
Consegue detectar boa parte das adulterações de arquivo, analisando estrutura e imagem. O que ela não resolve sozinha é o documento autêntico com conteúdo falso. Para isso, é preciso cruzar com outras fontes, e a Sumsub aponta a checagem visual entre as camadas mais expostas da verificação.
Papel ainda é problema para leitura automática?
Ainda é. Segundo a AIIM e a Deep Analysis, 61% dos processos de IDP incluem documentos em papel, 48% das empresas esperavam aumento do volume nos 12 meses seguintes e apenas 1% acreditava que estaria completamente sem papel em 2026. Fax aparecia em 37% dos processos.
Por que o PDF nem sempre mostra o que está no arquivo?
Porque o formato é versátil. O ITI registra que o PDF admite inserção de informações e outros objetos gráficos em camadas, alterando o visual do conteúdo. Por isso a leitura confiável analisa a estrutura do arquivo, e não apenas o que aparece na tela.
A leitura automática funciona com documento assinado digitalmente?
Funciona, e ganha uma camada extra. A assinatura digital fica vinculada ao documento de tal modo que qualquer alteração posterior a torna inválida, segundo o ITI. Isso permite verificar integridade e cadeia de certificação, além de extrair e conferir o conteúdo.
Preciso de um modelo treinado para cada tipo de documento?
Não necessariamente. É justamente essa a diferença em relação ao gabarito: modelos de linguagem lidam com layouts que nunca viram, sem treino específico. Configuração continua sendo necessária, mas na forma de regras de negócio e checklists, não de mapeamento de posição campo a campo.
Quanto tempo leva para implantar leitura automática?
Depende da complexidade das regras, dos tipos de documento e das integrações. Na Dynadok, a implantação leva de 1 a 4 meses, segundo a empresa. O relatório da AIIM e da Deep Analysis aponta integração com sistemas existentes como a segunda maior preocupação das empresas.
Qual a maior preocupação das empresas ao adotar essa tecnologia?
Segurança e privacidade dos dados processados, segundo a pesquisa da AIIM e da Deep Analysis. Em seguida vêm a integração com sistemas existentes e a precisão e confiabilidade da extração. As três respondem por boa parte das objeções em projetos de IDP.
Como medir se o projeto deu certo?
Pelo tempo de processamento, pela taxa de documentos que seguem sem intervenção humana, pela taxa de exceções e pela qualidade das decisões, não apenas por corte de pessoal. Na pesquisa da AIIM e da Deep Analysis, 50% apontam redução de tempo como medida de sucesso, contra 30% para redução de headcount.
O que é processamento direto sem intervenção?
É o documento que percorre todo o fluxo, da entrada à gravação no sistema, sem revisão humana, porque passou em todas as regras e ficou acima do limiar de confiança. É um dos componentes de precisão listados pela AIIM e pela Deep Analysis e a métrica mais direta de maturidade do fluxo.
Por onde começar a automatizar a leitura de documentos?
Escolha um tipo documental de alto volume e regras claras, defina o checklist e o limiar de confiança, estruture a fila de exceção com dono definido, integre a saída ao sistema que já usa e registre a trilha de cada decisão desde o primeiro dia.
Conclusão
A IA lê um documento em oito etapas encadeadas, e cada uma pode falhar de um jeito diferente: captura, pré-processamento, OCR, layout, classificação, extração, validação e decisão. Entender esse caminho é o que permite avaliar fornecedor, definir limiar, desenhar a fila de exceção e cumprir o que o art. 20 da LGPD exige de quem decide de forma automatizada. Com 78% das empresas pesquisadas já operacionais com IA e automação média de 63% dos documentos, a pergunta deixou de ser se a tecnologia funciona e passou a ser como implantá-la com controle. Solicite uma demonstração da Dynadok e veja o ciclo completo aplicado aos documentos da sua operação.
Como citar este artigo
ABNT: DYNADOK. Como a IA lê um documento: entenda o passo a passo por trás da tecnologia. Blog Dynadok, 7 set. 2026. Disponível em: https://blog.dynadok.com/ia/como-a-ia-le-um-documento/. Acesso em: 7 set. 2026.
APA: Dynadok. (2026, 7 de setembro). Como a IA lê um documento: entenda o passo a passo por trás da tecnologia. Blog Dynadok. https://blog.dynadok.com/ia/como-a-ia-le-um-documento/
Referências
AIIM; DEEP ANALYSIS. Market Momentum Index: Intelligent Document Processing (IDP) Survey 2025. 2025. Disponível em: https://start.docuware.com/hubfs/2025/Resources/DocuWare-IDP-Market%20Momentum%20Index%20IDP%20Survey%202025.pdf. Acesso em: 7 set. 2026.
BANCO CENTRAL DO BRASIL. Circular nº 3.978, de 23 de janeiro de 2020. Brasília: BCB, 2020. Disponível em: https://normativos.bcb.gov.br/Lists/Normativos/Attachments/50905/Circ_3978_v3_P.pdf. Acesso em: 7 set. 2026.
BRASIL. Lei nº 13.709, de 14 de agosto de 2018 (Lei Geral de Proteção de Dados Pessoais). Brasília: Presidência da República, 2018. Disponível em: https://www.planalto.gov.br/ccivil_03/_ato2015-2018/2018/lei/l13709.htm. Acesso em: 7 set. 2026.
BRASIL. Medida Provisória nº 2.200-2, de 24 de agosto de 2001. Brasília: Presidência da República, 2001. Disponível em: https://www.planalto.gov.br/ccivil_03/mpv/antigas_2001/2200-2.htm. Acesso em: 7 set. 2026.
DYNADOK. Documento digitalizado tem validade jurídica? O que diz a lei. Blog Dynadok, 2026. Disponível em: https://blog.dynadok.com/administracao/documento-digitalizado-tem-validade-juridica-o-que-diz-a-lei/. Acesso em: 7 set. 2026.
DYNADOK. Validação automática de documentos com IA. Dynadok, 2026. Disponível em: https://dynadok.com/. Acesso em: 7 set. 2026.
INSTITUTO NACIONAL DE TECNOLOGIA DA INFORMAÇÃO. Certificação Digital: perguntas frequentes. Gov.br, atualizado em 6 mar. 2026. Disponível em: https://www.gov.br/iti/pt-br/acesso-a-informacao/perguntas-frequentes/certificacao-digital. Acesso em: 7 set. 2026.
INSTITUTO NACIONAL DE TECNOLOGIA DA INFORMAÇÃO. VALIDAR: página de dúvidas. ITI, 2026. Disponível em: https://validar.iti.gov.br/duvidas.html. Acesso em: 7 set. 2026.
SERASA EXPERIAN. Setor financeiro enfrentou alta de quase 10% nas tentativas de fraude no 1º semestre. Serasa Experian, 20 ago. 2026. Disponível em: https://www.serasaexperian.com.br/sala-de-imprensa/setor-financeiro-enfrentou-alta-de-quase-10-por-cento-nas-tentativas-de-fraude-no-1-semestre-revela-serasa-experian/. Acesso em: 7 set. 2026.
SUMSUB. Identity Fraud Report 2025-2026. Sumsub, 25 nov. 2025. Disponível em: https://sumsub.com/newsroom/sumsubs-annual-report-fraud-shifts-to-complex-multi-step-schemes-in-2025-agentic-ai-scams-poised-to-surge-in-2026/. Acesso em: 7 set. 2026.
TRIBUNAL DE JUSTIÇA DO DISTRITO FEDERAL E DOS TERRITÓRIOS. Falsificação de documento particular. Direito Fácil, 12 nov. 2021. Disponível em: https://www.tjdft.jus.br/institucional/imprensa/campanhas-e-produtos/direito-facil/edicao-semanal/falsificacao-de-documento-particular. Acesso em: 7 set. 2026.
Calculadora de ROI da Validação Documental com IA
Use a calculadora de ROI da Dynadok: ajuste 3 dados da sua operação e veja, na hora, quanto a conferência manual custa hoje — e quanto volta ao seu caixa com a validação documental com IA.
Dados da operação
Esses 3 dados descrevem como funciona a sua conferência de documentos hoje — é com eles que calculamos o custo atual da operação e a economia ao automatizar com IA. Não precisa ser exato: uma boa estimativa já gera um resultado confiável.
Considere o volume mensal de páginas que sua equipe precisa receber, organizar, conferir, validar e atualizar nos sistemas. Não sabe o total? Estime: documentos recebidos no mês × média de páginas por documento.
Processa 100 mil páginas ou mais por mês? Converse com um especialista para um plano sob medida.
Inclua o ciclo completo: abrir o documento, extrair dados, conferir regras, registrar o resultado e devolver pendências. Estudos de mercado apontam de 3 a 10 minutos por página — se nunca mediu, mantenha os 5 min, uma média conservadora.
Digite apenas o salário mensal de quem confere esses documentos hoje (ex.: analista, assistente administrativo), sem encargos. A calculadora acrescenta sozinha os encargos e benefícios, multiplicando por 1,7 — aproximadamente o custo real de um funcionário para a empresa.
O resultado é gerado depois do cálculo e atualizado sempre que você mudar os dados.
Você mudou os dados. Clique em Recalcular para atualizar o resultado.
O resultado da sua calculadora de ROI aparece aqui
Ajuste os dados da operação e clique em “Calcular minha economia” para ver uma prévia feita com os números do seu cenário.
Identificamos
alto potencial de economia
mais barato por mês que a operação manual
Estimativa de R$ 526.400 de volta ao seu caixa por ano
Libere o resultado completo
Preencha seus dados para ver a economia mensal em reais, o comparativo de custos e as horas liberadas na sua equipe.
Seus dados ficam seguros. Um especialista da Dynadok pode entrar em contato para ajudar na sua análise.
Economia anual estimada
Equivale a R$ 43.867 por mês
Estimativa conservadoraROI estimado (mensal)
A cada R$ 1 investido no plano, cerca de R$ 4,43 deixam de ser gastos na operação manual.
Redução do custo operacional
Você deixa de gastar cerca de 8 de cada 10 reais que o trabalho mecânico de conferência consome hoje.
Sua operação manual ESTIMADA hoje
Com um tempo médio de 5 minutos por página, um profissional valida cerca de 12 páginas por hora. Em uma jornada de 7 horas, são 84 páginas por dia — e, em 20 dias úteis, cerca de 1.680 páginas por mês. Como sua operação processa 20.000 páginas por mês, o volume equivale ao trabalho de aproximadamente 12 profissionais. Nesta avaliação, consideramos que cerca de 80% desse esforço é trabalho operacional mecânico — o equivalente a 10 profissionais e 1.333 horas por mês. São esses números que usamos em todo o resultado.
Com a Dynadok, todo o trabalho operacional — mecânico, repetitivo e manual — passa a ser feito pela IA. Isso libera cerca de 80% do time para outras frentes; os demais deixam a conferência página a página e passam a atuar apenas na validação final e no tratamento de exceções.
Comparativo de custos
O que você libera com a Dynadok
Ganhos além da economia
A redução de custo é só uma parte. Validar documentos com a IA da Dynadok também transforma a operação:
O que hoje leva horas passa a ser feito em minutos ou segundos, acelerando a resposta ao seu cliente.
Regras claras e validações automatizadas reduzem erros em tarefas repetitivas e não conformidades.
Valide grandes volumes, em qualquer formato ou layout, sem aumentar o time na mesma proporção.
Sua equipe sai das tarefas manuais e passa a cuidar de análises e decisões que fazem o negócio crescer.
Estimativa ilustrativa da calculadora de ROI. Jornada de 7 h/dia em 20 dias úteis (140 h/mês) por profissional e fator de provisão de 1,7 sobre o salário base. A economia compara o custo da mão de obra dedicada ao trabalho mecânico de conferência (cerca de 80% do esforço total; os demais profissionais seguem na validação final e em exceções) com o custo do plano Dynadok para o mesmo volume de páginas.
Gostou deste artigo?
Envie para quem também vai aproveitar este conteúdo.