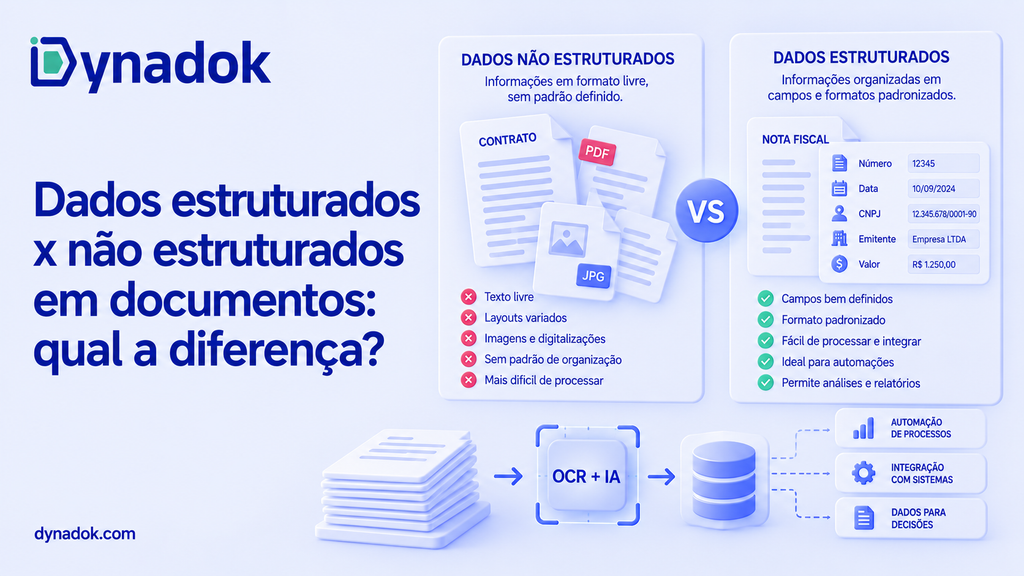
Dados estruturados seguem um esquema fixo de campos e cabem em linhas e colunas, como o XML de uma NF-e; dados não estruturados não têm formato predefinido, como um contrato em PDF, uma foto de RG ou um ASO manuscrito. O dado estruturado é lido por sistema, o não estruturado exige interpretação. A IA de validação documental converte o segundo no primeiro e aplica regras de conferência em escala.
Prompt copiado! É só colar no Gemini.
Pontos-chave
- Dados estruturados têm esquema fixo e cabem em tabelas; não estruturados não têm formato predefinido; semiestruturados usam marcadores como JSON e XML, segundo a IBM.
- Dados não estruturados representam 90% dos dados gerados pelas empresas e crescem a 3 vezes a taxa dos estruturados, segundo a IBM.
- Segundo Adam Wright, research manager da IDC, “o equilíbrio entre dados estruturados e não estruturados está mudando”, com os estruturados crescendo mais rápido por causa da automação e da IA.
- O Decreto nº 10.278/2020 define metadados como “dados estruturados que permitem classificar, descrever e gerenciar documentos” e exige 8 metadados mínimos em todo documento digitalizado.
- A NF-e modelo 55 é o documento estruturado por excelência no Brasil: existe só em formato digital, com validade jurídica garantida por assinatura digital e recepção pelo Fisco, segundo a SEF/MG.
- O mercado global de processamento inteligente de documentos (IDP) valia USD 2,45 bilhões em 2024 e deve chegar a USD 46,23 bilhões em 2033, segundo a IMARC Group.
- Segundo a Dynadok, a validação automática de documentos estruturados, semiestruturados, não estruturados e manuscritos reduz até 95% do tempo gasto com conferência.
O que são dados estruturados, semiestruturados e não estruturados em documentos?
Dados estruturados, semiestruturados e não estruturados são três classificações do dado conforme o formato e a existência (ou não) de um esquema predefinido, segundo a IBM. Em documentos empresariais, os três tipos convivem no mesmo dossiê: um XML de nota fiscal, um e-mail com anexos e uma ficha preenchida à mão.
O que é um dado estruturado em um documento?
Dado estruturado é a informação organizada em formato claro e predefinido, com campos fixos, tipos e restrições que um sistema valida antes de armazenar. Segundo a IBM, dados estruturados têm esquema fixo e cabem em linhas e colunas, como nomes e números de telefone, e ficam em planilhas e bancos relacionais consultados por SQL, linguagem criada pela própria IBM em 1974.
Quanto a validação manual custa para a sua empresa hoje?
Ajuste 3 dados da sua operação e veja, na hora, quanto a conferência manual consome do seu caixa — e quanto volta para ele com a validação de documentos com IA.
de volta ao seu caixa — R$ 43.867 por mês
Cenário-exemplo: 20 mil páginas/mês, 5 min por página. Faça a conta com os números da sua operação.O exemplo brasileiro mais claro é a Nota Fiscal Eletrônica. Segundo a Secretaria de Estado de Fazenda de Minas Gerais, a NF-e modelo 55 é um documento de existência digital, emitido e armazenado eletronicamente, com validade jurídica garantida pela assinatura digital do remetente e pela recepção pelo Fisco antes do fato gerador. Cada campo do XML tem nome, posição e formato definidos, e por isso o destinatário elimina a digitação da nota na recepção de mercadorias.
O que é um dado semiestruturado?
Dado semiestruturado é a ponte entre os dois extremos: não tem modelo rígido, mas usa metadados, como tags e marcadores, para identificar campos. Segundo a IBM, os exemplos clássicos são JSON, CSV e XML, e o e-mail é o caso mais citado: cabeçalho e assunto seguem formato padronizado, enquanto o corpo é texto livre.
Em documentos empresariais, o semiestruturado aparece em formulários com campos fixos e preenchimento variável: ficha de matrícula, ASO com carimbo e assinatura, comprovante de endereço.
O que é um dado não estruturado?
Dado não estruturado é a informação sem formato predefinido, armazenada no formato nativo e só definida quando alguém precisa usá-la. Segundo a IBM, os exemplos textuais são e-mails, documentos de texto e transcrições de chamadas; os não textuais são imagens, vídeos e dados de sensores.
Em uma operação documental, o não estruturado é a regra: a foto do RG, o contrato social escaneado, o PGR de dezenas de páginas, a certidão com carimbo. O valor está lá, mas nenhum sistema tradicional o lê sem uma camada de interpretação.
Por que a diferença entre dados estruturados e não estruturados importa para a empresa?
A diferença importa porque o dado não estruturado é a maioria e o mais caro de tratar. Segundo a IBM, conjuntos de dados não estruturados representam 90% de todos os dados gerados pelas empresas e, para a maioria das organizações, crescem a 3 vezes a taxa dos dados estruturados.
Ao mesmo tempo, a demanda por dado estruturado nunca foi tão alta. Segundo Adam Wright, research manager da pesquisa Global DataSphere da IDC, “o equilíbrio entre dados estruturados e não estruturados está mudando”. Wright explica que os dados não estruturados continuam inundando o mundo digital, mas o crescimento mais rápido dos estruturados reflete a ênfase em sistemas que capturam, organizam e operacionalizam dados para automação, IA e decisão em tempo real.
Para quem confere documentos, cada campo preso em um PDF ou em uma imagem precisa ser lido, digitado e conferido por uma pessoa. A tabela reúne os números que dimensionam o problema.
| Indicador | Número | Ano de referência | Fonte |
|---|---|---|---|
| Participação dos dados não estruturados nos dados gerados por empresas | 90% | 2025 | IBM |
| Velocidade de crescimento dos dados não estruturados em relação aos estruturados | 3 vezes | 2025 | IBM |
| Mercado global de processamento inteligente de documentos (IDP) | USD 2,45 bilhões | 2024 | IMARC Group |
| Projeção do mercado global de IDP | USD 46,23 bilhões | 2033 | IMARC Group |
| Taxa de erro de caractere (CER) de LLM multimodal em manuscrito moderno (benchmark IAM) | 1,71% | 2025 | Crosilla, Klic e Colavizza (arXiv) |
| Assertividade declarada na validação de inscrições por IA (Vitru Educação) | 90% | 2025 | Dynadok (depoimento) |
Fonte: elaboração própria com base em IBM (2025), IMARC Group (2025), Crosilla, Klic e Colavizza (2025) e Dynadok (2026).
A leitura é uma só: o dado não estruturado domina o volume, o mercado de IDP cresce a 35,20% ao ano segundo a IMARC Group porque as empresas precisam converter esse volume em dado estruturado, e a leitura por IA já atinge erro abaixo de 2% em manuscrito moderno.
O que a legislação brasileira exige de dados e metadados em documentos?
A legislação brasileira não usa a expressão “dado não estruturado”, mas exige que todo documento carregue dados estruturados sobre si mesmo: os metadados. O Decreto nº 10.278, de 18 de março de 2020, art. 3º, inciso II, define metadados como “dados estruturados que permitem classificar, descrever e gerenciar documentos”. No inciso I, documento digitalizado é o “representante digital do processo de digitalização do documento físico e seus metadados”.
O art. 5º do Decreto nº 10.278/2020 determina que o documento digitalizado destinado a produzir efeitos legais perante o poder público deve ser assinado com certificado ICP-Brasil, seguir o Anexo I e conter, no mínimo, os metadados do Anexo II. O Anexo I fixa 300 dpi e PDF/A para textos impressos e manuscritos, e 600 dpi para plantas e mapas. O Anexo II lista 8 metadados obrigatórios: assunto, autor, data e local da digitalização, identificador do documento digital, responsável pela digitalização, título, tipo documental e hash da imagem.
A base é anterior. A Lei nº 8.159, de 8 de janeiro de 1991, art. 3º, considera gestão de documentos “o conjunto de procedimentos e operações técnicas referentes à sua produção, tramitação, uso, avaliação e arquivamento”, e o art. 2º alcança os arquivos “qualquer que seja o suporte da informação”. No plano internacional, o Dublin Core é um vocabulário de quinze elementos de descrição, padronizado em 1998 e publicado como ISO 15836, segundo a DCMI.
| Norma ou padrão | O que exige em relação a dados estruturados | Quem responde | Referência |
|---|---|---|---|
| Decreto nº 10.278/2020, art. 3º | Define metadados como dados estruturados que classificam, descrevem e gerenciam documentos | Quem digitaliza (possuidor do documento ou terceiro contratado) | Art. 3º, II e art. 8º |
| Decreto nº 10.278/2020, Anexo II | 8 metadados mínimos: assunto, autor, data e local, identificador, responsável, título, tipo documental e hash | Quem digitaliza | Anexo II, item a |
| Decreto nº 10.278/2020, Anexo I | 300 dpi e PDF/A para textos impressos e manuscritos; 600 dpi para plantas e mapas | Quem digitaliza | Anexo I |
| Lei nº 8.159/1991, art. 3º | Gestão de documentos em todas as fases: produção, tramitação, uso, avaliação e arquivamento | Poder público e arquivos privados | Art. 3º e art. 11 |
| Ajuste SINIEF 07/2005 (NF-e) | Documento fiscal de existência exclusivamente digital, em XML assinado e autorizado pelo Fisco | Emitente e destinatário | SEF/MG, perguntas frequentes |
| Dublin Core (ISO 15836) | Quinze elementos padronizados de descrição: título, autor, assunto, data, tipo, formato, identificador | Quem descreve o recurso | DCMI, versão 1.1 |
Fonte: Brasil (Decreto nº 10.278/2020 e Lei nº 8.159/1991), SEF/MG e DCMI.
O ponto prático: ao exigir tipo documental, autor, data e hash em cada arquivo, o Decreto nº 10.278/2020 exige que a empresa extraia dados estruturados de um documento não estruturado. Fazer isso à mão para milhares de páginas por mês é o gargalo que a IA resolve.
Como as empresas tratam documentos não estruturados hoje e onde o processo falha?
Hoje a maioria das operações trata o documento não estruturado com trabalho humano: alguém abre o arquivo, localiza o campo, digita o valor em planilha ou sistema e confere a regra de negócio de cabeça. A Dynadok descreve esse cenário com quatro adjetivos: não escala, é caro, é lento e gera erros.
O caso da Unicesumar mostra o tamanho da estrutura que esse modelo exige. Segundo Karla Lemos, Gerente de CSC da Unicesumar, em depoimento no site da Dynadok, a análise de documentos do Prouni chegava a envolver 25 pessoas antes da IA. Os gargalos se repetem em qualquer setor:
- A conferência depende de digitação: o CPF impresso na CNH e o CPF escrito à mão na ficha só são comparados se alguém os transcrever, e cada transcrição é uma chance de erro.
- Cada layout novo quebra a rotina: um comprovante de endereço de outra concessionária ou um ASO de outra clínica exige reaprender onde está cada campo.
- Os metadados exigidos pelo Decreto nº 10.278/2020 ficam vazios: tipo documental, autor, data e hash raramente são preenchidos quando o processo é manual.
- O cruzamento entre documentos não acontece: a razão social do contrato social, o CNPJ da CND e o nome no ASO ficam em documentos separados, sem conferência automática.
- O erro não deixa rastro: sem trilha de auditoria, ninguém sabe quem validou o quê, quando e com qual critério.
Nenhum desses gargalos se resolve com mais planilhas. O problema é de formato: a informação está presa em pixels e texto livre.
Como transformar documentos não estruturados em dados estruturados passo a passo?
Transformar documentos não estruturados em dados estruturados é um pipeline de sete etapas em que a leitura é só o começo. A Dynadok combina OCR, visão computacional, LLMs e RAG para executar esse fluxo em produção.
- Inventarie os tipos de documento e classifique cada um por grau de estrutura. Liste o que a operação recebe e marque o grau de estrutura de cada tipo. Esse inventário define a taxonomia documental que organiza os arquivos e os metadados de cada tipo.
- Defina o esquema de saída antes de ler qualquer página. Para cada tipo, especifique os campos que precisam virar dado estruturado: titular, CPF ou CNPJ, datas de emissão e validade, valores, número do documento. Inclua os 8 metadados do Anexo II do Decreto nº 10.278/2020 quando o documento for digitalizado.
- Capture com qualidade mínima e classifique na entrada. Oriente quem envia a fotografar o documento inteiro, com boa iluminação; o Anexo I do decreto fixa 300 dpi para textos. A classificação automática identifica o tipo pelo conteúdo, não pelo nome do arquivo.
- Extraia os dados com a tecnologia adequada ao formato. Texto impresso pede OCR; campos manuscritos pedem HTR ou LLM multimodal, que, segundo Crosilla, Klic e Colavizza, atingem CER de 1,71% em manuscrito moderno.
- Valide cada dado contra regras de formato e negócio. Dígito verificador de CPF e CNPJ, datas possíveis, validade vencida, campos obrigatórios presentes. A Dynadok aplica checklists personalizados por tipo de documento e por processo.
- Cruze os dados entre documentos e sistemas. O CPF extraído da ficha é comparado com o CPF do RG; o CNPJ do contrato social, com o da CND. Divergências viram alertas, e o dado consistente segue para o ERP ou o GED via API.
- Roteie exceções para revisão humana e meça a taxa de automação. Cada leitura recebe um score de confiança; scores baixos vão para uma pessoa, scores altos seguem sozinhos. O indicador de maturidade é o percentual de documentos processados sem intervenção.
Executado em ordem, o pipeline entrega dado estruturado, auditável e cruzado a partir de documentos que nasceram sem estrutura.
Como escolher a tecnologia para ler dados estruturados e não estruturados em documentos?
A escolha depende do grau de estrutura do documento e do volume. Um XML de NF-e não precisa de IA: o sistema lê os campos diretamente. Já um contrato escaneado ou um ASO com anotações à mão exige interpretação, e o mercado responde com o processamento inteligente de documentos, que a IMARC Group avaliou em USD 2,45 bilhões em 2024. A tabela compara as quatro abordagens mais comuns.
| Critério | Digitação manual e planilha | OCR clássico | IDP com templates | IA generativa com validação (Dynadok) |
|---|---|---|---|---|
| Documento estruturado (XML, CSV) | Redigita o que já é dado | Não se aplica | Lê por integração | Lê por integração e cruza com os demais |
| Documento semiestruturado (formulário, ASO, comprovante) | Lê e digita campo a campo | Extrai texto sem saber qual campo é qual | Extrai se o layout foi mapeado antes | Identifica os campos em qualquer layout |
| Documento não estruturado (contrato, certidão, foto) | Leitura integral por pessoa | Texto corrido sem estrutura | Falha fora do template | Interpreta o conteúdo e extrai os campos definidos |
| Manuscrito | Depende da caligrafia e da pessoa | Não lê | Não lê | Lê com HTR e LLM multimodal (CER de 1,71% no benchmark IAM) |
| Validação e cruzamento | Manual, de memória | Nenhum | Regras fixas por template | Checklists personalizados e cruzamento entre documentos |
| Novo layout | Retreinamento da equipe | Sem campos | Novo template | Sem mapeamento prévio |
| Escala | Cresce com contratação | Limitada pela conferência posterior | Média | Alta, com revisão humana só nas exceções |
Fonte: elaboração própria com base em IBM (2025), Crosilla, Klic e Colavizza (2025), IMARC Group (2025) e Dynadok (2026).
O critério decisivo não é “ler” e sim “validar”. Como resume Cássio Lapertosa, Diretor de TI da Emccamp, sobre a IA da Dynadok: a tecnologia “não só lê campos, mas interpreta documentos cruzando informações”. Quem compara ferramentas deve testar isso com um dossiê real, com XML, PDF, foto e manuscrito misturados.
Quais erros mais comuns ao lidar com dados não estruturados em documentos?
Os erros mais comuns nascem de tratar o documento não estruturado como se fosse estruturado, ou de parar na leitura sem validar. Cada erro abaixo tem uma consequência mensurável:
- Confundir digitalizar com estruturar: escanear um contrato gera um PDF, não dados; sem extração e metadados, o Decreto nº 10.278/2020 não reconhece o arquivo como documento digitalizado válido perante o poder público.
- Mapear templates para cada layout: fornecedores, clínicas e concessionárias mudam o modelo sem avisar; cada mudança quebra a extração e cria uma fila de exceções.
- Ignorar o manuscrito: campos preenchidos à mão ficam fora da automação e viram o trabalho residual; a tecnologia já lê manuscrito moderno com CER de 1,71%, segundo Crosilla, Klic e Colavizza.
- Confiar na leitura sem cruzar: um “7” lido como “1” no CPF passa despercebido se ninguém compara o dado com o RG; o cruzamento transforma erro de leitura em alerta.
- Não registrar metadados e trilha de auditoria: sem tipo documental, autor, data e hash, a empresa não prova a integridade exigida pelo art. 4º do Decreto nº 10.278/2020.
- Automatizar sem revisão humana por exceção: LLMs podem gerar texto plausível em trechos ilegíveis; sem score de confiança e roteamento para pessoas, o erro raro vira erro silencioso.
Evitar esses erros exige desenhar o processo para que o dado extraído seja validado, cruzado e auditado antes de alimentar qualquer sistema.
Como a Dynadok transforma documentos não estruturados em dados validados?
A Dynadok é uma plataforma brasileira de validação automática de documentos com IA que identifica e extrai informações de documentos com dados estruturados, semiestruturados, não estruturados e escritos à mão, em imagens ou PDFs, inclusive arquivos digitalizados com centenas de páginas. A tecnologia une LLMs, OCR, visão computacional e RAG, e o resultado da leitura passa por checklists personalizados e cruzamento entre documentos antes de chegar ao sistema do cliente via API.
Segundo a Dynadok, a validação automática reduz até 95% do tempo gasto com conferência e torna as validações até 10 vezes mais rápidas. No cenário-exemplo da calculadora de ROI, com 20 mil páginas por mês a 5 minutos por página, a operação manual custa R$ 56.667 por mês contra R$ 12.800 com a plataforma, economia de 77% ou R$ 526.400 por ano, segundo a Dynadok.
Os clientes confirmam o efeito sobre dados não estruturados. Segundo Chrystiano Mincoff, Diretor Executivo de Experiência e Permanência da Vitru Educação, “chegamos a uma assertividade de 90%”, com 9 em cada 10 inscrições validadas pela IA. Na Unicesumar, Karla Lemos, Gerente de CSC, relata que a operação do Prouni passou de até 25 pessoas para 10 com a Dynadok. Para campos preenchidos à mão, a plataforma aplica a mesma esteira, como detalha o artigo sobre leitura de documentos manuscritos por IA. Os termos técnicos deste guia estão definidos no glossário de validação e automação de documentos da Dynadok.
Perguntas frequentes sobre dados estruturados e não estruturados em documentos
O que é dado estruturado em uma frase?
Dado estruturado é a informação organizada em formato predefinido, com campos fixos que cabem em linhas e colunas e que um sistema valida antes de armazenar. Segundo a IBM, é o tipo guardado em planilhas e bancos relacionais. No Brasil, o XML da NF-e é o exemplo mais comum.
O que é dado não estruturado em uma frase?
Dado não estruturado é a informação sem formato predefinido, guardada no formato nativo: e-mails, documentos de texto, imagens, vídeos e transcrições. Segundo a IBM, esses conjuntos representam 90% dos dados gerados pelas empresas. Em operações documentais, é a foto do RG e o contrato escaneado.
O que é dado semiestruturado?
Dado semiestruturado não tem modelo rígido, mas usa metadados, como tags e marcadores, para identificar campos. Segundo a IBM, JSON, CSV e XML são os exemplos clássicos, e o e-mail é o caso mais citado, com cabeçalho padronizado e corpo livre. Formulários, ASOs e comprovantes de endereço entram nessa categoria.
Um PDF é dado estruturado ou não estruturado?
Depende do conteúdo, não da extensão. Um PDF gerado por sistema com campos de formulário carrega dados semiestruturados; um PDF escaneado é uma imagem, portanto não estruturado. O que importa é se os campos podem ser lidos por sistema sem interpretação.
A NF-e é um documento estruturado?
Sim. Segundo a SEF/MG, a NF-e modelo 55 é um documento de existência digital, em XML, com validade jurídica garantida pela assinatura digital do remetente e pela recepção pelo Fisco antes do fato gerador. O DANFE é só a representação gráfica.
O que são metadados de um documento?
Metadados são dados sobre o documento: tipo, autor, datas, identificador, hash. O Decreto nº 10.278/2020, art. 3º, II, define metadados como “dados estruturados que permitem classificar, descrever e gerenciar documentos”. São eles que tornam um documento não estruturado localizável e auditável.
Quais metadados o Decreto nº 10.278/2020 exige?
O Anexo II do Decreto nº 10.278/2020 exige 8 metadados mínimos para todo documento digitalizado: assunto, autor, data e local da digitalização, identificador do documento digital, responsável pela digitalização, título, tipo documental e hash da imagem. Órgãos públicos registram ainda classe, destinação e prazo de guarda.
Digitalizar um documento é o mesmo que estruturar os dados dele?
Não. Digitalizar converte papel em imagem, que continua sendo dado não estruturado. Estruturar é extrair os campos e os metadados e gravá-los em formato que um sistema leia. O Decreto nº 10.278/2020 só reconhece o documento digitalizado quando ele vem acompanhado dos metadados.
Qual resolução o decreto exige na digitalização?
O Anexo I do Decreto nº 10.278/2020 fixa 300 dpi para textos impressos e manuscritos, com ou sem ilustração, em PDF/A, e 600 dpi para plantas e mapas, em PNG. A compressão, quando usada, deve ser sem perda de informação.
O que é o Dublin Core e por que ele importa para documentos?
O Dublin Core Metadata Element Set é um vocabulário de quinze elementos para descrever recursos, padronizado em 1998 como IETF RFC 2413 e publicado como ISO 15836, segundo a DCMI. Título, autor, assunto, data e identificador coincidem com os metadados do Decreto nº 10.278/2020.
Por que dados não estruturados crescem mais rápido?
Porque não exigem definição prévia. Segundo a IBM, como não é preciso predefinir o dado não estruturado, ele pode ser coletado com rapidez, e por isso cresce a 3 vezes a taxa do dado estruturado na maioria das organizações.
Os dados estruturados estão perdendo importância?
Não. Segundo Adam Wright, research manager da IDC, o equilíbrio entre os dois tipos está mudando porque as organizações dependem cada vez mais de dados estruturados para automação, IA e decisão em tempo real. O não estruturado domina o volume; o estruturado cresce mais rápido.
O que é IDP (processamento inteligente de documentos)?
IDP combina OCR, visão computacional, aprendizado de máquina e processamento de linguagem natural para classificar documentos, extrair dados com contexto e validar informações. Segundo a IMARC Group, o mercado global de IDP valia USD 2,45 bilhões em 2024 e deve chegar a USD 46,23 bilhões em 2033.
OCR resolve documentos não estruturados?
Só em parte. O OCR converte imagem de texto em texto editável, mas devolve texto corrido sem identificar qual trecho é o CPF ou a data. Estruturar o dado exige extração com contexto, feita por IDP ou LLM, seguida de validação por regras e cruzamento.
A IA lê campos manuscritos em documentos?
Sim. Segundo o estudo de Crosilla, Klic e Colavizza publicado no arXiv em 2025, LLMs multimodais atingiram CER de 1,71% no benchmark IAM de manuscrito moderno em inglês, patamar que a literatura considera muito bom (abaixo de 5%). Em documentos históricos em outros idiomas o erro passou de 20%.
O que é CER e qual valor é aceitável?
CER (Character Error Rate) é o percentual de caracteres errados na transcrição. Segundo Crosilla, Klic e Colavizza, CER abaixo de 5% é muito bom, entre 5% e 10% é bom e acima de 10% indica qualidade ruim. Em campos críticos, validação por regras e cruzamento completam a leitura.
Como a IA valida um dado depois de extraí-lo?
Aplicando regras de formato (dígito verificador, datas válidas, campos obrigatórios) e cruzando o dado com outros documentos e sistemas. Na Dynadok, checklists personalizados e cruzamento entre documentos fazem essa etapa, e um score de confiança decide se o caso segue sozinho ou vai para revisão humana.
Preciso trocar meu sistema para estruturar dados de documentos com IA?
Não. Segundo a Dynadok, a plataforma se adapta ao ambiente atual e se integra aos sistemas que a empresa já usa por API, entregando os dados estruturados ao ERP, GED ou CRM existente. A implantação leva de 1 a 4 meses, segundo a empresa.
Quanto custa manter a conferência manual de documentos não estruturados?
No cenário-exemplo da calculadora de ROI da Dynadok, com 20 mil páginas por mês a 5 minutos por página, a operação manual custa R$ 56.667 por mês, contra R$ 12.800 com a plataforma: economia de 77%, ou R$ 526.400 por ano, segundo a Dynadok. A cobrança é feita por página processada pela IA.
Qual o primeiro passo para sair do dado não estruturado?
Inventariar os tipos de documento recebidos, classificar cada um como estruturado, semiestruturado ou não estruturado e definir os campos e metadados de saída, incluindo os 8 do Anexo II do Decreto nº 10.278/2020. Só depois escolher a tecnologia de extração e desenhar validação, cruzamento e revisão por exceção.
Conclusão
A diferença entre dados estruturados e não estruturados em documentos é a diferença entre o que um sistema lê sozinho e o que exige interpretação. Segundo a IBM, os dados não estruturados representam 90% de tudo o que as empresas geram, e o Decreto nº 10.278/2020 exige que cada documento digitalizado carregue 8 metadados estruturados. Fechar essa distância com IA que extrai, valida e cruza os dados é o que a Dynadok faz em produção. Solicite uma demonstração da validação automática de documentos com IA e veja como o seu dossiê, com XML, PDF, foto e manuscrito misturados, vira dado estruturado e validado.
Como citar este artigo
ABNT: DYNADOK. Dados estruturados x não estruturados em documentos: qual a diferença? Blog Dynadok, 07 set. 2026. Disponível em: https://blog.dynadok.com/ia/dados-estruturados-x-nao-estruturados-em-documentos-qual-a-diferenca/. Acesso em: 07 set. 2026.
APA: Dynadok. (2026, 7 de setembro). Dados estruturados x não estruturados em documentos: qual a diferença? Blog Dynadok. https://blog.dynadok.com/ia/dados-estruturados-x-nao-estruturados-em-documentos-qual-a-diferenca/
Referências
BRASIL. Decreto nº 10.278, de 18 de março de 2020. Estabelece a técnica e os requisitos para a digitalização de documentos públicos ou privados. Brasília: Presidência da República, 2020. Disponível em: https://www.planalto.gov.br/ccivil_03/_ato2019-2022/2020/decreto/d10278.htm. Acesso em: 07 set. 2026.
BRASIL. Lei nº 8.159, de 8 de janeiro de 1991. Dispõe sobre a política nacional de arquivos públicos e privados. Brasília: Presidência da República, 1991. Disponível em: https://www.planalto.gov.br/ccivil_03/leis/l8159.htm. Acesso em: 07 set. 2026.
CROSILLA, Giorgia; KLIC, Lukas; COLAVIZZA, Giovanni. Benchmarking Large Language Models for Handwritten Text Recognition. arXiv, 2025. Disponível em: https://arxiv.org/abs/2503.15195. Acesso em: 07 set. 2026.
DUBLIN CORE METADATA INITIATIVE. Dublin Core Metadata Element Set, Version 1.1: Reference Description. DCMI, 2012. Disponível em: https://www.dublincore.org/specifications/dublin-core/dces/. Acesso em: 07 set. 2026.
DYNADOK. Glossário de Validação e Automação de Documentos. Dynadok, 2026. Disponível em: https://dynadok.com/glossario-de-validacao-e-automacao-de-documentos/. Acesso em: 07 set. 2026.
DYNADOK. IA lê documento manuscrito? Entenda o que a tecnologia já consegue fazer. Blog Dynadok, 2026. Disponível em: https://blog.dynadok.com/ia/ia-le-documento-manuscrito-entenda-o-que-a-tecnologia-ja-consegue-fazer/. Acesso em: 07 set. 2026.
DYNADOK. O que é taxonomia documental e como organizar seus arquivos. Blog Dynadok, 2026. Disponível em: https://blog.dynadok.com/ia/o-que-e-taxonomia-documental-e-como-organizar-seus-arquivos/. Acesso em: 07 set. 2026.
DYNADOK. Validação automática de documentos com IA. Dynadok, 2026. Disponível em: https://dynadok.com/. Acesso em: 07 set. 2026.
IBM. Structured vs. unstructured data: What’s the difference? IBM Think, 2025. Disponível em: https://www.ibm.com/think/topics/structured-vs-unstructured-data. Acesso em: 07 set. 2026.
IDC. Worldwide Global DataSphere Structured and Unstructured Data Forecast, 2025-2029. IDC, 2025. Disponível em: https://my.idc.com/getdoc.jsp?containerId=US52800025&pageType=PRINTFRIENDLY. Acesso em: 07 set. 2026.
IMARC GROUP. Intelligent Document Processing Market Size, Share, Trends and Forecast, 2025-2033. IMARC, 2025. Disponível em: https://www.imarcgroup.com/intelligent-document-processing-market. Acesso em: 07 set. 2026.
MINAS GERAIS. Secretaria de Estado de Fazenda. Nota Fiscal Eletrônica: perguntas frequentes. Portal SPED MG. Disponível em: https://portalsped.fazenda.mg.gov.br/spedmg/nfe/Perguntas-Frequentes/respostas_i/index.html. Acesso em: 07 set. 2026.
Calculadora de ROI da Validação Documental com IA
Use a calculadora de ROI da Dynadok: ajuste 3 dados da sua operação e veja, na hora, quanto a conferência manual custa hoje — e quanto volta ao seu caixa com a validação documental com IA.
Dados da operação
Esses 3 dados descrevem como funciona a sua conferência de documentos hoje — é com eles que calculamos o custo atual da operação e a economia ao automatizar com IA. Não precisa ser exato: uma boa estimativa já gera um resultado confiável.
Considere o volume mensal de páginas que sua equipe precisa receber, organizar, conferir, validar e atualizar nos sistemas. Não sabe o total? Estime: documentos recebidos no mês × média de páginas por documento.
Processa 100 mil páginas ou mais por mês? Converse com um especialista para um plano sob medida.
Inclua o ciclo completo: abrir o documento, extrair dados, conferir regras, registrar o resultado e devolver pendências. Estudos de mercado apontam de 3 a 10 minutos por página — se nunca mediu, mantenha os 5 min, uma média conservadora.
Digite apenas o salário mensal de quem confere esses documentos hoje (ex.: analista, assistente administrativo), sem encargos. A calculadora acrescenta sozinha os encargos e benefícios, multiplicando por 1,7 — aproximadamente o custo real de um funcionário para a empresa.
O resultado é gerado depois do cálculo e atualizado sempre que você mudar os dados.
Você mudou os dados. Clique em Recalcular para atualizar o resultado.
O resultado da sua calculadora de ROI aparece aqui
Ajuste os dados da operação e clique em “Calcular minha economia” para ver uma prévia feita com os números do seu cenário.
Identificamos
alto potencial de economia
mais barato por mês que a operação manual
Estimativa de R$ 526.400 de volta ao seu caixa por ano
Libere o resultado completo
Preencha seus dados para ver a economia mensal em reais, o comparativo de custos e as horas liberadas na sua equipe.
Seus dados ficam seguros. Um especialista da Dynadok pode entrar em contato para ajudar na sua análise.
Economia anual estimada
Equivale a R$ 43.867 por mês
Estimativa conservadoraROI estimado (mensal)
A cada R$ 1 investido no plano, cerca de R$ 4,43 deixam de ser gastos na operação manual.
Redução do custo operacional
Você deixa de gastar cerca de 8 de cada 10 reais que o trabalho mecânico de conferência consome hoje.
Sua operação manual ESTIMADA hoje
Com um tempo médio de 5 minutos por página, um profissional valida cerca de 12 páginas por hora. Em uma jornada de 7 horas, são 84 páginas por dia — e, em 20 dias úteis, cerca de 1.680 páginas por mês. Como sua operação processa 20.000 páginas por mês, o volume equivale ao trabalho de aproximadamente 12 profissionais. Nesta avaliação, consideramos que cerca de 80% desse esforço é trabalho operacional mecânico — o equivalente a 10 profissionais e 1.333 horas por mês. São esses números que usamos em todo o resultado.
Com a Dynadok, todo o trabalho operacional — mecânico, repetitivo e manual — passa a ser feito pela IA. Isso libera cerca de 80% do time para outras frentes; os demais deixam a conferência página a página e passam a atuar apenas na validação final e no tratamento de exceções.
Comparativo de custos
O que você libera com a Dynadok
Ganhos além da economia
A redução de custo é só uma parte. Validar documentos com a IA da Dynadok também transforma a operação:
O que hoje leva horas passa a ser feito em minutos ou segundos, acelerando a resposta ao seu cliente.
Regras claras e validações automatizadas reduzem erros em tarefas repetitivas e não conformidades.
Valide grandes volumes, em qualquer formato ou layout, sem aumentar o time na mesma proporção.
Sua equipe sai das tarefas manuais e passa a cuidar de análises e decisões que fazem o negócio crescer.
Estimativa ilustrativa da calculadora de ROI. Jornada de 7 h/dia em 20 dias úteis (140 h/mês) por profissional e fator de provisão de 1,7 sobre o salário base. A economia compara o custo da mão de obra dedicada ao trabalho mecânico de conferência (cerca de 80% do esforço total; os demais profissionais seguem na validação final e em exceções) com o custo do plano Dynadok para o mesmo volume de páginas.
Gostou deste artigo?
Envie para quem também vai aproveitar este conteúdo.