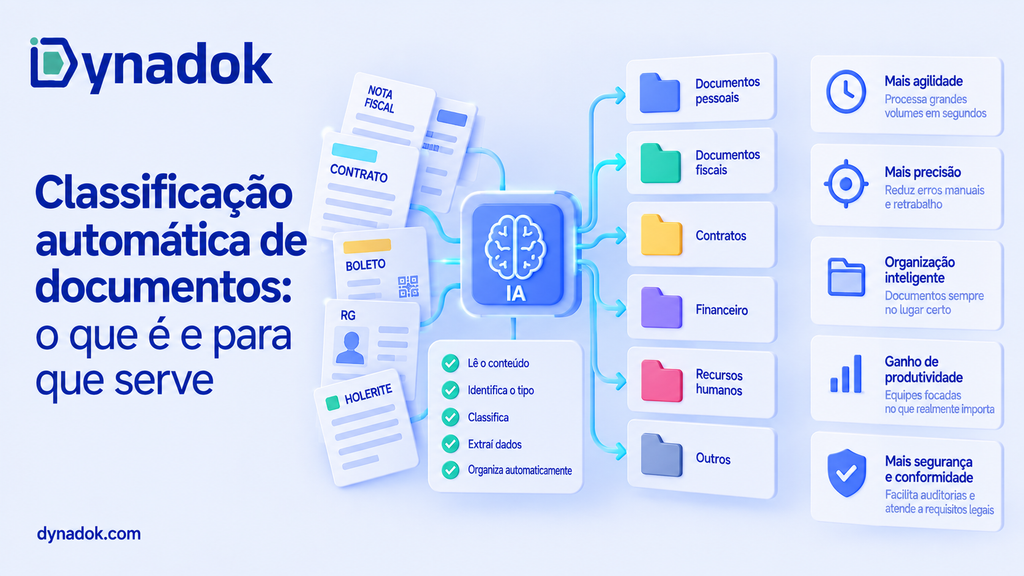
Classificação automática de documentos é a identificação, por software, do tipo de cada arquivo recebido (RG, nota fiscal, ASO, contrato, certidão) sem triagem humana, a partir do conteúdo e do layout, e não do nome do arquivo. Ela serve para encaminhar cada documento ao checklist de validação certo, preencher os metadados que o Decreto 10.278/2020 exige e eliminar a fila de conferência manual.
Prompt copiado! É só colar no Gemini.
Pontos-chave
- Classificação automática de documentos é a primeira decisão da esteira documental: só depois de saber que o arquivo é um ASO, e não um PGR, o sistema aplica as regras daquele tipo.
- Modelos de IA que combinam imagem, texto e layout atingem 96,17% de acurácia no RVL-CDIP, benchmark de 400.000 imagens de documentos em 16 classes, segundo o paper DocFormer (AWS AI, 2021).
- Em documentos reais de uma instituição de ensino superior brasileira, um experimento com aprendizado de máquina obteve 98% de acurácia média, segundo Flores e Kantorski, no X Congresso Nacional de Arquivologia (2024).
- O Decreto 10.278/2020 lista “Tipo documental” entre os metadados mínimos de todo documento digitalizado com valor legal.
- O mercado global de Intelligent Document Processing (IDP) foi avaliado em US$ 3,0 bilhões em 2025 e deve chegar a US$ 29,7 bilhões em 2033, segundo a Grand View Research (2026).
- Segundo a Dynadok, a validação automática com IA reduz até 95% do tempo gasto com validação; na Vitru Educação, 9 em cada 10 inscrições foram validadas por IA sem apoio humano.
O que é classificação automática de documentos?
Classificação automática de documentos é o processo em que um sistema de inteligência artificial lê um arquivo (imagem, PDF, foto de celular ou digitalização) e atribui a ele um tipo documental de uma lista predefinida, chamada taxonomia. A decisão sai do conteúdo e da estrutura visual, e por isso funciona mesmo quando o arquivo se chama “digitalizacao_003.pdf”.
O termo vem da arquivologia. A Lei 8.159/1991 define gestão de documentos, no art. 3º, como o conjunto de procedimentos e operações técnicas referentes à produção, tramitação, uso, avaliação e arquivamento, e a classificação é a operação que dá a cada documento o seu lugar nessa estrutura. O que a IA muda é o executor: a classificação deixa de depender de uma pessoa abrir cada arquivo e acontece em segundos, no recebimento.
Quanto a validação manual custa para a sua empresa hoje?
Ajuste 3 dados da sua operação e veja, na hora, quanto a conferência manual consome do seu caixa — e quanto volta para ele com a validação de documentos com IA.
de volta ao seu caixa — R$ 43.867 por mês
Cenário-exemplo: 20 mil páginas/mês, 5 min por página. Faça a conta com os números da sua operação.A referência acadêmica para essa tarefa é o RVL-CDIP, criado por Adam W. Harley, Alex Ufkes e Konstantinos G. Derpanis (ICDAR 2015). O RVL-CDIP reúne 400.000 imagens de documentos em 16 classes, com 25.000 por classe, entre elas carta, formulário, e-mail, manuscrito, fatura, currículo e memorando. É nesse conjunto que os modelos são comparados, e por isso os números de acurácia da área quase sempre se referem a ele.
Na prática corporativa brasileira, as classes são outras: RG, CNH, comprovante de endereço, contrato social, CNDs, ASO, PGR, notas fiscais, histórico escolar. A taxonomia precisa ser desenhada para a operação, como explica o guia sobre taxonomia documental e organização de arquivos do blog da Dynadok.
Qual é a diferença entre classificar, extrair e validar um documento?
Classificar responde “que documento é este?”; extrair responde “quais dados ele contém?”; validar responde “este documento está correto, vigente e coerente com os demais?”. As etapas são sequenciais: a extração depende do tipo (um ASO tem campos que uma CND não tem) e a validação depende dos dados extraídos. Um erro de classificação contamina tudo o que vem depois: o sistema procura campos que não existem e aprova ou reprova pelo motivo errado.
Intelligent Document Processing (IDP) é o nome de mercado da tecnologia que faz as três etapas juntas. Segundo a Grand View Research (2026), soluções de IDP usam machine learning, processamento de linguagem natural, OCR e visão computacional para capturar dados, classificar e extrair as informações relevantes.
Por que a classificação automática de documentos importa para a operação?
A classificação manual é o gargalo invisível das operações que recebem documentos em volume, porque cada arquivo precisa ser aberto, reconhecido e encaminhado antes de qualquer análise começar. O McKinsey Global Institute, no relatório The social economy (2012), estimou que o trabalhador de interação médio gasta quase 20% da semana procurando informação interna ou localizando colegas, e que um registro pesquisável reduz em até 35% o tempo dessa busca.
A classificação automática indexa o documento na entrada, e por isso ele pode ser localizado depois por tipo, titular, validade e processo, em vez de por nome de pasta. O ganho de precisão também é mensurável. Segundo o paper DocFormer (Appalaraju e colegas, AWS AI, ICCV 2021), no RVL-CDIP os modelos só de imagem chegam a 89,80% de acurácia (ensemble de CNNs de Harley et al., 2015), os só de texto, como o BERT-base, a 89,81%, e os multimodais a 95,65% (LayoutLMv2-large) e 96,17% (DocFormer-base).
No Brasil, Débora Flores e Gustavo Zanini Kantorski apresentaram no X Congresso Nacional de Arquivologia (2024) um experimento com aprendizado de máquina em documentos reais de uma instituição de ensino superior e relataram acurácia média de 98% na previsão das tipologias documentais. O mercado acompanha: a Grand View Research avaliou o mercado global de IDP em US$ 3,0 bilhões em 2025, com projeção de US$ 29,7 bilhões em 2033, a 33,8% ao ano; o segmento de machine learning respondeu por 46,6% desse mercado em 2025.
| Indicador | Número | Ano | Fonte |
|---|---|---|---|
| Tempo da semana gasto procurando informação interna | quase 20% | 2012 | McKinsey Global Institute |
| Acurácia de classificação só com imagem (RVL-CDIP) | 89,80% | 2015 | Harley et al., citado em DocFormer |
| Acurácia de modelo multimodal (RVL-CDIP) | 96,17% | 2021 | DocFormer, AWS AI |
| Acurácia em documentos de instituição de ensino brasileira | 98% | 2024 | Flores e Kantorski, X CNA |
| Mercado global de IDP | US$ 3,0 bilhões | 2025 | Grand View Research |
| Mercado global de IDP (projeção) | US$ 29,7 bilhões | 2033 | Grand View Research |
| Inscrições validadas por IA sem apoio humano (Vitru Educação) | 9 em cada 10 | declaração de cliente | Dynadok |
Fonte: elaboração própria com base em McKinsey Global Institute (2012), Appalaraju et al. (2021), Flores e Kantorski (2024), Grand View Research (2026) e Dynadok (2026).
Andrew Joiner, CEO da Hyperscience, ao comentar o primeiro Magic Quadrant do Gartner dedicado a IDP, publicado em 3 de setembro de 2025 com 18 fornecedores avaliados, afirmou que a demanda por soluções nativas em IA “está disparando”. Um Magic Quadrant próprio é sinal de que a categoria amadureceu.
O que a legislação e as normas brasileiras exigem na classificação de documentos?
A classificação de documentos no Brasil tem base legal explícita, e a exigência recai sobre os metadados. O Decreto 10.278/2020, que regulamenta a digitalização com valor legal, define no art. 3º, inciso II, metadados como “dados estruturados que permitem classificar, descrever e gerenciar documentos”. O art. 5º exige que o documento digitalizado que valha perante o poder público seja assinado com ICP-Brasil, siga o Anexo I e contenha os metadados do Anexo II.
O Anexo II é onde a classificação aparece nominalmente. Entre os oito metadados mínimos de todos os documentos estão “Tipo documental”, a configuração da espécie documental de acordo com a atividade que a gerou, e “Assunto”, palavras-chave de preenchimento livre ou com vocabulário controlado. Para pessoas jurídicas de direito público, o decreto acrescenta “Classe”, identificada com base em um plano de classificação, além de prazo de guarda e destinação prevista.
Segundo Sérgio Jacomino, Quinto Oficial de Registro de Imóveis da Capital de São Paulo, em artigo publicado pelo CNB/SP em junho de 2026, “não é possível falar em metadados sem a criação prévia de um vocabulário controlado”. Jacomino relata que documentos digitalizados chegam aos registros desestruturados e fora das diretivas do decreto, e defende que o sistema de recepção submeta cada arquivo a um escrutínio taxonômico digital. A classificação automática é esse escrutínio, aplicado por IA no envio.
| Norma | Item | Exigência | Responsável |
|---|---|---|---|
| Lei 8.159/1991 | Art. 3º | Gestão de documentos abrange produção, tramitação, uso, avaliação e arquivamento | Órgãos públicos e entidades de caráter público |
| Decreto 10.278/2020 | Art. 3º, II | Metadados são dados estruturados que permitem classificar, descrever e gerenciar documentos | Quem digitaliza |
| Decreto 10.278/2020 | Art. 5º, III e Anexo II (a) | Oito metadados mínimos, incluindo Tipo documental, Assunto, Autor, Título e Hash da imagem | Possuidor do documento físico (art. 8º, § 1º) |
| Decreto 10.278/2020 | Anexo II (b) | Classe, prazo de guarda, destinação prevista, gênero e data de produção | Pessoas jurídicas de direito público interno |
| Decreto 10.278/2020 | Anexo I | Resolução mínima de 300 dpi para textos e 600 dpi para plantas e mapas, formato PDF/A para textos | Quem digitaliza |
| Decreto 10.278/2020 | Art. 10, II | Armazenamento deve indexar metadados para localização e gerenciamento | Quem armazena |
| e-ARQ Brasil versão 2 (Conarq) | Esquema de metadados | Metadados de identificação da classe e de gerenciamento da classe, ligados ao plano de classificação e à tabela de temporalidade | Sistemas informatizados de gestão arquivística (SIGAD) |
| ISO 15489-1:2016 | Conceitos e princípios | Metadados para documentos e sistemas de documentos, independentemente de estrutura ou forma | Organizações de qualquer setor |
Fonte: Presidência da República (Lei 8.159/1991 e Decreto 10.278/2020), Conarq (e-ARQ Brasil, nota explicativa 2020) e ISO (2016).
Dois pontos merecem atenção. O decreto não se aplica a documentos nato-digitais, de identificação e de porte obrigatório (art. 2º, parágrafo único), mas a lógica de classificar e indexar vale para todos, porque é ela que permite localizar e auditar o acervo. E o e-ARQ Brasil, cuja primeira versão saiu em 2006 e cuja versão 2 foi elaborada pelo Conarq entre 2017 e 2020, organiza os metadados de classificação em identificação da classe e gerenciamento da classe. Um sistema que classifica automaticamente já nasce com esses eventos registrados.
Como a classificação de documentos é feita hoje e onde ela falha?
Na maioria das operações, a classificação ainda é feita por pessoas, em três variantes: o analista abre cada arquivo e o move para a pasta certa; quem envia escolhe o tipo em um formulário; ou o GED aplica regras por nome de arquivo ou palavra-chave. As três funcionam com volume baixo e layouts estáveis, e quebram quando a operação cresce ou os documentos vêm de terceiros, cada um em um formato.
O custo aparece em dois lugares. No tempo: documento mal classificado é informação que ninguém encontra. Na qualidade: quando dois analistas classificam o mesmo arquivo de jeitos diferentes, a validação aplica checklists diferentes, e a auditoria não reconstrói por que o documento foi aprovado.
- Classificação pelo nome do arquivo: “contrato_final_v2.pdf” pode ser uma procuração; o nome é dado por quem envia, não pelo conteúdo.
- Escolha do tipo por quem envia: o fornecedor marca “ASO” e anexa o PCMSO; a pendência só aparece dias depois.
- Regras fixas de palavra-chave: a regra que procura “ATESTADO DE SAÚDE OCUPACIONAL” falha quando o OCR lê “ATESTAD0” ou a clínica usa outro título.
- PDFs combinados: um arquivo com RG, CPF e comprovante recebe um tipo só, e os demais somem do controle de validade.
- Critério pessoal: sem taxonomia escrita, cada analista cria sua categoria (“Diversos”, “Verificar”), e a pasta de exceções cresce mais que as oficiais.
- Retrabalho na validação: o documento classificado errado chega ao checklist errado e volta para quem enviou com uma orientação que não faz sentido.
O guia sobre esteira de validação documental e como montá-la descreve a identificação e classificação como o segundo dos sete estágios da esteira, depois da captura e antes da extração. Tudo o que vem depois herda o erro.
Como implantar a classificação automática de documentos passo a passo?
- Levante os tipos que a operação recebe de verdade. Liste os documentos a partir dos processos (admissão, matrícula, homologação de fornecedor, crédito), não das pastas atuais. CND federal, estadual, municipal e trabalhista são quatro tipos, não um.
- Escreva a taxonomia com vocabulário controlado. Dê um nome oficial a cada tipo, mapeie os sinônimos (“nota”, “NF”, “DANFE”) para ele e garanta que cada documento tenha um único encaixe possível. Como lembra Sérgio Jacomino, metadado sem vocabulário controlado não é metadado.
- Defina os metadados obrigatórios por tipo. Use o Anexo II do Decreto 10.278/2020 como piso: tipo documental, assunto, autor, título, identificador, data da digitalização, responsável e hash. Acrescente titular, validade e processo vinculado, que são os campos que sustentam o controle de vencimentos.
- Separe uma amostra rotulada por tipo. Reúna exemplos reais de cada classe, incluindo fotos de celular, digitalizações ruins e manuscritos. A amostra mede a acurácia do classificador antes de ligar o fluxo e revela tipos que a taxonomia esqueceu.
- Configure o classificador e o limiar de confiança. Todo modelo devolve um score de confiança por documento; defina a partir de qual score o tipo é aceito automaticamente e abaixo de qual o arquivo vai para revisão humana. É esse limiar, não o modelo, que controla a taxa de automação e o risco.
- Encadeie a classificação ao checklist de validação. O tipo identificado deve acionar, sem intervenção, o checklist daquele documento: campos obrigatórios, validade, assinaturas e cruzamento com o dossiê. Classificar sem validar apenas organiza a pasta.
- Meça e ajuste desde a primeira semana. Acompanhe a acurácia por tipo, o percentual de documentos que caem em revisão e o tamanho da categoria “Outros”. Tipo com acurácia baixa pede mais exemplos; “Outros” crescendo pede um tipo novo na taxonomia.
Como escolher a abordagem de classificação de documentos?
Há três abordagens em uso, e a escolha depende da variedade dos layouts, do volume e do custo de um erro. Regras por nome de arquivo ou palavra-chave do OCR são baratas e previsíveis, mas exigem uma regra por layout. Modelos treinados só em imagem ou só em texto resolvem casos padronizados. Modelos multimodais, que combinam imagem, texto e a posição de cada campo, são os que lidam com documentos de terceiros em formatos desconhecidos.
Os números do RVL-CDIP dão a régua. Segundo o paper DocFormer, o VGG-16, só de imagem, chega a 88,33% de acurácia; o BERT-base, só de texto, a 89,81%; o LayoutLMv2-large, multimodal, a 95,65%; e o DocFormer-base, a 96,17%. O mesmo paper mostra o peso do pré-treinamento: sem ele, o DocFormer cai para 93,95%.
| Critério | Regras (nome, palavra-chave) | Modelo de imagem ou de texto | IA multimodal (imagem + texto + layout) |
|---|---|---|---|
| Acurácia de referência no RVL-CDIP | não medida no benchmark | 88,33% a 89,81% | 95,65% a 96,17% |
| Layouts novos e documentos de terceiros | exige regra nova por layout | degrada com layout fora do treino | reconhece pelo conteúdo e pela estrutura |
| Manuscritos e fotos de celular | não trata | parcial | trata, com score de confiança por documento |
| Custo de manutenção | alto e contínuo | médio (retreino por classe) | baixo após implantação; ajuste por limiar de confiança |
| Explicabilidade do erro | alta | média | exige revisão humana dos casos de baixa confiança |
| Indicação | poucos tipos, layouts fixos, baixo volume | tipos padronizados, volume médio | muitos tipos, muitos emissores, alto volume |
Fonte: elaboração própria com base em Appalaraju et al. (2021) e Grand View Research (2026).
Dois critérios decidem a compra. O primeiro é o tratamento das exceções: a plataforma precisa devolver um score por documento e encaminhar os de baixa confiança para uma fila humana. O segundo é a integração: o tipo identificado precisa acionar o checklist e alimentar o sistema de destino via API. Os termos técnicos dessa comparação (IDP, OCR, score de confiança, human in the loop, taxa de automação) estão definidos no glossário de validação e automação de documentos da Dynadok.
Quais erros comprometem a classificação automática de documentos?
- Automatizar sem taxonomia escrita: se dois analistas discordam sobre o que é “comprovante de renda”, o modelo vai aprender a discordância; a consequência é acurácia baixa que nenhum retreino resolve.
- Confiar na classe “Outros”: tudo o que o modelo não reconhece vai para uma categoria genérica sem dono; a consequência é um acervo paralelo sem validação nem controle de vencimento.
- Aceitar qualquer score: sem limiar de confiança, o sistema aprova classificações duvidosas; a consequência é um ASO validado como PCMSO e um checklist errado aplicado em silêncio.
- Ignorar PDFs com vários documentos: a consequência é perder o controle dos documentos internos e reprovar dossiês completos por “falta” de um documento que está lá.
- Treinar só com documentos limpos: a amostra tem PDFs nato-digitais, mas a operação recebe fotos de celular; a consequência é acurácia alta no teste e baixa em produção.
- Classificar e parar: o tipo é identificado, mas não aciona validação nem cruzamento; a consequência é uma pasta organizada com documentos vencidos dentro.
- Esquecer os metadados legais: sem tipo documental, hash e identificador registrados, a consequência é perder a equiparação legal do art. 5º do Decreto 10.278/2020 perante o poder público.
Como a Dynadok classifica e valida documentos?
A Dynadok é uma plataforma brasileira de validação automática de documentos com IA que identifica o tipo de cada arquivo e o valida em vários formatos e layouts, incluindo documentos estruturados, semiestruturados, não estruturados e escritos à mão. Segundo a Dynadok, a tecnologia combina LLMs, OCR, visão computacional e RAG, reduz até 95% do tempo gasto com validação e torna as validações até 10x mais rápidas.
A classificação é o ponto de partida do fluxo: o documento enviado pelo cliente, candidato, aluno ou fornecedor é reconhecido, direcionado ao checklist personalizado daquele tipo, cruzado com os demais documentos do dossiê e, se houver não conformidade, devolvido em segundos a quem enviou. Os documentos processados cobrem identificação pessoal (RG, CNH, CPF), SST e terceiros (contrato social, CNPJ, PGR, PCMSO, ASO, CNDs, notas fiscais), comprovantes de endereço, registros profissionais, documentos educacionais (Prouni, FIES) e documentação trabalhista (eSocial, DCTFWeb).
Os resultados declarados pelos clientes dão a escala. Segundo Chrystiano Mincoff, Diretor Executivo de Experiência e Permanência da Vitru Educação, “9 em cada 10 inscrições foram validadas por inteligência artificial”. Segundo Karla Lemos, Gerente de CSC da Unicesumar, a análise de documentos do Prouni passou de até 25 pessoas para 10. Cássio Lapertosa, Diretor de TI da Emccamp, resume: a tecnologia “não só lê campos, mas interpreta documentos cruzando informações”. A implantação leva de 1 a 4 meses e a cobrança é por página processada, segundo a Dynadok.
Perguntas frequentes sobre classificação automática de documentos
O que é classificação automática de documentos em uma frase?
Classificação automática de documentos é a atribuição, por inteligência artificial, de um tipo documental (RG, nota fiscal, ASO, contrato) a cada arquivo recebido, com base no conteúdo e no layout, sem que uma pessoa precise abrir o documento.
Para que serve a classificação automática de documentos?
Serve para três coisas: direcionar cada documento ao checklist de validação correto, preencher os metadados que a legislação exige (tipo documental, assunto, classe) e permitir que o acervo seja localizado por tipo, titular e validade, e não por nome de pasta.
Classificação automática é a mesma coisa que OCR?
Não. OCR converte a imagem em texto; a classificação decide que documento aquele texto e aquela imagem representam. O OCR é um dos insumos do classificador, junto com a visão computacional e o layout, e os modelos mais precisos combinam os três.
Qual é a acurácia de um classificador de documentos com IA?
No benchmark RVL-CDIP, com 16 classes, modelos multimodais atingem 95,65% a 96,17% de acurácia, segundo o paper DocFormer (2021). Em documentos reais de uma instituição de ensino brasileira, Flores e Kantorski (2024) relataram 98% de acurácia média.
O que é o RVL-CDIP?
RVL-CDIP é o dataset de referência para classificação de imagens de documentos, criado por Harley, Ufkes e Derpanis (ICDAR 2015). Reúne 400.000 imagens em 16 classes, com 25.000 por classe, divididas em 320.000 para treino, 40.000 para validação e 40.000 para teste.
A classificação de documentos é obrigatória por lei no Brasil?
Para documentos digitalizados que pretendam valer perante o poder público, sim. O art. 5º do Decreto 10.278/2020 exige os metadados mínimos do Anexo II, entre eles “Tipo documental” e “Assunto”. Para órgãos públicos, o decreto acrescenta “Classe”.
Quais são os metadados mínimos do Decreto 10.278/2020?
Para todos os documentos, são oito: assunto, autor, data e local da digitalização, identificador do documento digital, responsável pela digitalização, título, tipo documental e hash da imagem. Pessoas jurídicas de direito público acrescentam classe, data de produção, destinação prevista, gênero e prazo de guarda.
O Decreto 10.278/2020 vale para documentos nato-digitais?
Não. O parágrafo único do art. 2º exclui documentos nato-digitais, de identificação, de porte obrigatório, do sistema financeiro nacional, em microfilme e audiovisuais. Mesmo assim, classificar e indexar esses documentos continua necessário para localizá-los, validá-los e auditá-los.
O que é taxonomia documental e por que ela vem antes da IA?
Taxonomia documental é a lista controlada de categorias e tipos que a organização usa para classificar seus documentos. Ela vem antes porque o modelo aprende a taxonomia que recebe: se os tipos se sobrepõem, a classificação automática reproduz a ambiguidade em escala.
O que é score de confiança e como usá-lo?
Score de confiança é a nota que o modelo atribui à sua própria classificação de cada documento. Acima de um limiar definido pela operação, o tipo é aceito automaticamente; abaixo dele, o documento vai para revisão humana. O limiar é o controle entre taxa de automação e risco.
A IA classifica documentos manuscritos e fotos de celular?
Sim, desde que o classificador combine visão computacional com OCR e tenha sido treinado com exemplos reais dessas condições. Segundo a Dynadok, sua IA identifica documentos estruturados, semiestruturados, não estruturados e escritos à mão, em qualquer layout.
O que acontece quando um PDF contém vários documentos?
Um classificador adequado separa o arquivo em páginas ou blocos, identifica o tipo de cada um e registra cada documento individualmente. Sem isso, o PDF recebe um único tipo e os demais documentos ficam fora do controle de validade e do checklist.
Quanto tempo leva para implantar a classificação automática?
Depende do número de tipos, das regras e das integrações. Segundo a Dynadok, a implantação de sua plataforma de validação, que inclui a classificação, leva de 1 a 4 meses. A maior parte desse tempo vai para escrever a taxonomia e os checklists.
Preciso trocar meu GED ou ERP para ter classificação automática?
Não. A classificação funciona como uma camada que recebe o documento, identifica o tipo, valida e devolve o resultado ao sistema de destino via API. Segundo a Dynadok, sua plataforma se integra aos sistemas que a empresa já utiliza.
Como a classificação automática se relaciona com a LGPD?
Documentos como RG, CNH e contratos estão cheios de dados pessoais protegidos pela LGPD (Lei 13.709/2018). Classificar cada documento no recebimento é o que permite aplicar minimização, controle de acesso por tipo, prazos de guarda e trilha de auditoria por documento.
O que é IDP e qual é o tamanho desse mercado?
IDP (Intelligent Document Processing) é a tecnologia que captura, classifica e extrai dados de documentos com machine learning, PLN, OCR e visão computacional. Segundo a Grand View Research, o mercado global de IDP valeu US$ 3,0 bilhões em 2025 e chegará a US$ 29,7 bilhões em 2033.
Regras por palavra-chave ainda servem para alguma coisa?
Servem para operações com poucos tipos, layouts fixos e volume baixo, em que cada regra pode ser mantida à mão. Falham quando os documentos vêm de muitos emissores em formatos diferentes, porque cada layout novo exige uma regra nova e o OCR imperfeito quebra as existentes.
Quais indicadores mostram que a classificação automática está funcionando?
Quatro: acurácia por tipo, medida contra uma amostra rotulada; percentual de documentos que caem em revisão humana; tamanho da categoria “Outros”; e tempo entre envio e classificação. Se “Outros” cresce ou a revisão sobe, a taxonomia ou o limiar precisam de ajuste.
O que o e-ARQ Brasil diz sobre classificação?
O e-ARQ Brasil, modelo de requisitos do Conarq para sistemas de gestão arquivística, teve a primeira versão em 2006 e a versão 2 elaborada entre 2017 e 2020. Na versão 2, os metadados de classificação foram organizados em identificação da classe e gerenciamento da classe.
Qual é o primeiro passo para começar?
Escolher um processo de alto volume com tipos conhecidos (admissão, matrícula, terceiros, notas fiscais), escrever a taxonomia desse processo com vocabulário controlado e separar uma amostra real de cada tipo. Com isso pronto, configurar o classificador e o checklist é a parte rápida.
Conclusão
Classificação automática de documentos é a decisão que abre a esteira documental: sem saber o tipo, nenhum checklist, cruzamento ou controle de validade se aplica. A tecnologia já entrega 96,17% de acurácia no RVL-CDIP e 98% em documentos reais de uma instituição brasileira, e o Decreto 10.278/2020 já exige o tipo documental como metadado mínimo. O que separa organizar pastas de automatizar decisões é ligar a classificação à validação. Para ver isso na sua operação, solicite uma demonstração da validação automática de documentos com IA.
Como citar este artigo
ABNT: DYNADOK. Classificação automática de documentos: o que é, para que serve e como funciona com IA. Blog Dynadok, 07 set. 2026. Disponível em: https://blog.dynadok.com/ia/classificacao-automatica-de-documentos/. Acesso em: 07 set. 2026.
APA: Dynadok. (2026, 7 de setembro). Classificação automática de documentos: o que é, para que serve e como funciona com IA. Blog Dynadok. https://blog.dynadok.com/ia/classificacao-automatica-de-documentos/
Referências
APPALARAJU, Srikar; JASANI, Bhavan; KOTA, Bhargava Urala; XIE, Yusheng; MANMATHA, R. DocFormer: End-to-End Transformer for Document Understanding. ICCV, 2021. Disponível em: https://arxiv.org/abs/2106.11539. Acesso em: 07 set. 2026.
BRASIL. Decreto nº 10.278, de 18 de março de 2020. Estabelece a técnica e os requisitos para a digitalização de documentos públicos ou privados. Brasília: Presidência da República, 2020. Disponível em: https://www.planalto.gov.br/ccivil_03/_ato2019-2022/2020/decreto/d10278.htm. Acesso em: 07 set. 2026.
BRASIL. Lei nº 8.159, de 8 de janeiro de 1991. Dispõe sobre a política nacional de arquivos públicos e privados. Brasília: Presidência da República, 1991. Disponível em: https://www.planalto.gov.br/ccivil_03/leis/l8159.htm. Acesso em: 07 set. 2026.
BUSINESS WIRE. Hyperscience Named a Leader in the First-Ever Gartner Magic Quadrant for Intelligent Document Processing Solutions. Business Wire, 5 set. 2025. Disponível em: https://www.businesswire.com/news/home/20250905306651/en. Acesso em: 07 set. 2026.
CONSELHO NACIONAL DE ARQUIVOS (CONARQ). Nota explicativa: consulta pública para atualização do e-ARQ Brasil. Rio de Janeiro: Conarq, 2020. Disponível em: https://www.gov.br/conarq/pt-br/assuntos/noticias/conarq-abre-consulta-publica-visando-a-atualizacao-do-e-arq-brasil/Nota_explicativa_eARQ_2020.pdf/@@download/file. Acesso em: 07 set. 2026.
DYNADOK. Glossário de validação e automação de documentos. Dynadok, 2026. Disponível em: https://dynadok.com/glossario-de-validacao-e-automacao-de-documentos/. Acesso em: 07 set. 2026.
DYNADOK. O que é taxonomia documental e como organizar seus arquivos. Blog Dynadok, 25 ago. 2026. Disponível em: https://blog.dynadok.com/ia/o-que-e-taxonomia-documental-e-como-organizar-seus-arquivos/. Acesso em: 07 set. 2026.
DYNADOK. O que é uma esteira de validação documental e como montá-la. Blog Dynadok, 5 set. 2026. Disponível em: https://blog.dynadok.com/ia/o-que-e-uma-esteira-de-validacao-documental-e-como-monta-la/. Acesso em: 07 set. 2026.
DYNADOK. Validação automática de documentos com IA. Dynadok, 2026. Disponível em: https://dynadok.com/. Acesso em: 07 set. 2026.
FLORES, Débora; KANTORSKI, Gustavo Zanini. Arquivologia e Aprendizagem de Máquina: Classificação Automática de Documentos Arquivísticos. In: X Congresso Nacional de Arquivologia, Caderno de Resumos. Salvador: AABA/FNArq, 2024. Disponível em: https://arquivistica.fci.unb.br/au/arquivologia-e-aprendizagem-de-maquina-classificacao-automatica-de-documentos-arquivisticos/. Acesso em: 07 set. 2026.
GRAND VIEW RESEARCH. Intelligent Document Processing Market (2026-2033): Size, Share & Trends Analysis Report. Grand View Research, jun. 2026. Disponível em: https://www.grandviewresearch.com/industry-analysis/intelligent-document-processing-market-report. Acesso em: 07 set. 2026.
HARLEY, Adam W.; UFKES, Alex; DERPANIS, Konstantinos G. Dataset Card for RVL-CDIP. Hugging Face, 2015. Disponível em: https://huggingface.co/datasets/aharley/rvl_cdip. Acesso em: 07 set. 2026.
INTERNATIONAL ORGANIZATION FOR STANDARDIZATION (ISO). ISO 15489-1:2016. Information and documentation, Records management, Part 1: Concepts and principles. Genebra: ISO, 2016. Disponível em: https://www.iso.org/standard/62542.html. Acesso em: 07 set. 2026.
JACOMINO, Sérgio. SREI. Documentos digitalizados. Metadados mínimos exigidos para plataformização. CNB/SP, 30 jun. 2026. Disponível em: https://cnbsp.org.br/2026/06/30/artigo-srei-documentos-digitalizados-metadados-minimos-exigidos-para-plataformizacao-por-sergio-jacomino/. Acesso em: 07 set. 2026.
MCKINSEY GLOBAL INSTITUTE. The social economy: Unlocking value and productivity through social technologies. McKinsey & Company, jul. 2012. Disponível em: https://www.mckinsey.com/industries/hightech/our-insights/the-social-economy. Acesso em: 07 set. 2026.
Calculadora de ROI da Validação Documental com IA
Use a calculadora de ROI da Dynadok: ajuste 3 dados da sua operação e veja, na hora, quanto a conferência manual custa hoje — e quanto volta ao seu caixa com a validação documental com IA.
Dados da operação
Esses 3 dados descrevem como funciona a sua conferência de documentos hoje — é com eles que calculamos o custo atual da operação e a economia ao automatizar com IA. Não precisa ser exato: uma boa estimativa já gera um resultado confiável.
Considere o volume mensal de páginas que sua equipe precisa receber, organizar, conferir, validar e atualizar nos sistemas. Não sabe o total? Estime: documentos recebidos no mês × média de páginas por documento.
Processa 100 mil páginas ou mais por mês? Converse com um especialista para um plano sob medida.
Inclua o ciclo completo: abrir o documento, extrair dados, conferir regras, registrar o resultado e devolver pendências. Estudos de mercado apontam de 3 a 10 minutos por página — se nunca mediu, mantenha os 5 min, uma média conservadora.
Digite apenas o salário mensal de quem confere esses documentos hoje (ex.: analista, assistente administrativo), sem encargos. A calculadora acrescenta sozinha os encargos e benefícios, multiplicando por 1,7 — aproximadamente o custo real de um funcionário para a empresa.
O resultado é gerado depois do cálculo e atualizado sempre que você mudar os dados.
Você mudou os dados. Clique em Recalcular para atualizar o resultado.
O resultado da sua calculadora de ROI aparece aqui
Ajuste os dados da operação e clique em “Calcular minha economia” para ver uma prévia feita com os números do seu cenário.
Identificamos
alto potencial de economia
mais barato por mês que a operação manual
Estimativa de R$ 526.400 de volta ao seu caixa por ano
Libere o resultado completo
Preencha seus dados para ver a economia mensal em reais, o comparativo de custos e as horas liberadas na sua equipe.
Seus dados ficam seguros. Um especialista da Dynadok pode entrar em contato para ajudar na sua análise.
Economia anual estimada
Equivale a R$ 43.867 por mês
Estimativa conservadoraROI estimado (mensal)
A cada R$ 1 investido no plano, cerca de R$ 4,43 deixam de ser gastos na operação manual.
Redução do custo operacional
Você deixa de gastar cerca de 8 de cada 10 reais que o trabalho mecânico de conferência consome hoje.
Sua operação manual ESTIMADA hoje
Com um tempo médio de 5 minutos por página, um profissional valida cerca de 12 páginas por hora. Em uma jornada de 7 horas, são 84 páginas por dia — e, em 20 dias úteis, cerca de 1.680 páginas por mês. Como sua operação processa 20.000 páginas por mês, o volume equivale ao trabalho de aproximadamente 12 profissionais. Nesta avaliação, consideramos que cerca de 80% desse esforço é trabalho operacional mecânico — o equivalente a 10 profissionais e 1.333 horas por mês. São esses números que usamos em todo o resultado.
Com a Dynadok, todo o trabalho operacional — mecânico, repetitivo e manual — passa a ser feito pela IA. Isso libera cerca de 80% do time para outras frentes; os demais deixam a conferência página a página e passam a atuar apenas na validação final e no tratamento de exceções.
Comparativo de custos
O que você libera com a Dynadok
Ganhos além da economia
A redução de custo é só uma parte. Validar documentos com a IA da Dynadok também transforma a operação:
O que hoje leva horas passa a ser feito em minutos ou segundos, acelerando a resposta ao seu cliente.
Regras claras e validações automatizadas reduzem erros em tarefas repetitivas e não conformidades.
Valide grandes volumes, em qualquer formato ou layout, sem aumentar o time na mesma proporção.
Sua equipe sai das tarefas manuais e passa a cuidar de análises e decisões que fazem o negócio crescer.
Estimativa ilustrativa da calculadora de ROI. Jornada de 7 h/dia em 20 dias úteis (140 h/mês) por profissional e fator de provisão de 1,7 sobre o salário base. A economia compara o custo da mão de obra dedicada ao trabalho mecânico de conferência (cerca de 80% do esforço total; os demais profissionais seguem na validação final e em exceções) com o custo do plano Dynadok para o mesmo volume de páginas.
Gostou deste artigo?
Envie para quem também vai aproveitar este conteúdo.