---
source_url: "https://blog.dynadok.com/ia/o-que-e-extracao-de-dados-de-documentos-e-como-ela-funciona/"
title: "O que é extração de dados de documentos e como ela funciona"
generated_at: 2026-09-20T12:00:59Z
host: blog.dynadok.com
type: post
schema_types: [Article]
generator: geostack/1.0.0
---
## Structured data
```json
{
"@context": "https://schema.org",
"@graph": [
{
"@type": "Article",
"@id": "https://blog.dynadok.com/ia/o-que-e-extracao-de-dados-de-documentos-e-como-ela-funciona/#article",
"url": "https://blog.dynadok.com/ia/o-que-e-extracao-de-dados-de-documentos-e-como-ela-funciona/",
"headline": "O que é extração de dados de documentos e como ela funciona",
"datePublished": "2026-09-20T12:00:00+00:00",
"dateModified": "2026-09-13T21:49:18+00:00",
"inLanguage": "pt-BR",
"publisher": {
"@type": "Organization",
"name": "Blog Dynadok - Análise documental automatizada por I.A",
"url": "https://blog.dynadok.com/"
},
"description": "Extração de dados de documentos é o processo que lê um arquivo (PDF, imagem, foto de celular ou XML), localiza os campos relevantes e os converte em dados estruturados prontos para validação, cruzamento e integração. Ela funciona em etapas: captura, classificação, reconhecimento de texto (OCR ou HTR), compreensão do layout, extração dos campos, validação por regras e entrega ao sistema. A IA faz esse ciclo em segundos, com revisão humana só nas exceções. Resumir com IA ChatGPT Claude Perplexity Gemini Prompt copiado! É só colar no Gemini. Pontos-chave O que é extração de dados de documentos? Extração de dados de documentos é a leitura automática dos campos relevantes de um documento (nome, CPF, datas, valores, cláusulas) e sua conversão em dados estruturados que um sistema consegue validar, cruzar e integrar. O glossário da Dynadok define a extração como a leitura que transforma “imagens e PDFs em dados estruturados prontos para validação, cruzamento e integração com outros sistemas”. Qual a diferença entre OCR e extração de dados? OCR (reconhecimento óptico de caracteres) converte imagem de texto em texto editável e pesquisável; extração de dados identifica, dentro desse texto, qual trecho corresponde a cada campo. Segundo a Amazon Web Services, a Amazon Textract vai além do OCR simples para identificar, entender e extrair dados de formulários e tabelas, devolvendo campos, valores, relações entre eles e tabelas junto com scores de confiança. Calculadora de ROI Quanto a validação manual custa para a sua empresa hoje? Ajuste 3 dados da sua operação e veja, na hora, quanto a conferência manual consome do seu caixa — e quanto volta para ele com a validação de documentos com IA. Calcular minha economia Grátis · leva menos de 1 minuto Exemplo de resultado −77% de custo R$ 526.400/ano de volta ao seu caixa — R$ 43.867 por mês Operação manual hojeR$ 56.667/mês Com a DynadokR$ 12.800/mês Cenário-exemplo: 20 mil páginas/mês, 5 min por página. Faça a conta com os números da sua operação. Um exemplo torna a diferença concreta. O OCR aplicado a um ASO devolve um bloco de texto com nome, função, exames e a palavra “apto” em algum lugar. A extração devolve um registro: trabalhador, CPF, tipo de exame, data, médico responsável, resultado. Só o segundo formato permite verificar se o exame está no prazo e se o CPF confere com o RG anexado. O que sai da extração de dados? O resultado da extração é um conjunto de pares campo e valor, cada um com um score de confiança e, nas plataformas maduras, com a posição de origem na página. Segundo a AWS, cada elemento detectado pela Amazon Textract vem acompanhado do score de confiança correspondente, o que permite encaminhar resultados de baixa confiança para revisão humana. O dado confiável segue sozinho; o duvidoso vai para uma pessoa. Por que a extração de dados de documentos importa para a operação? A extração importa porque o volume de documentos sem estrutura cresce mais rápido do que qualquer equipe consegue digitar. Segundo a IBM, dados não estruturados representam 90% de todos os dados gerados pelas empresas e crescem a 3 vezes a taxa dos dados estruturados. A demanda por dado estruturado cresce na mesma velocidade. Segundo Adam Wright, research manager da pesquisa Global DataSphere da IDC, “o equilíbrio entre dados estruturados e não estruturados está mudando”, e o crescimento mais rápido dos estruturados reflete a ênfase em sistemas que capturam, organizam e operacionalizam dados para automação e IA. O mercado responde a essa pressão. Segundo a IMARC Group, o mercado global de processamento inteligente de documentos (IDP), categoria que tem a extração como núcleo, valia USD 2,45 bilhões em 2024 e deve chegar a USD 46,23 bilhões em 2033, com crescimento de 35,20% ao ano. Continue explorando Mais sobre a Dynadok As páginas mais visitadas para você ver como transformamos documentos em decisões. Calculadora de ROI Quanto a validação manual custa hoje? Grátis, 1 minuto. Cases e depoimentos Resultados reais de Cogna, Cenibra e Unicesumar. API de validação Integre ao seu sistema, ERP ou plataforma. Preços e cobrança Modelo simples, por páginas processadas. Quem somos Propósito, equipe e DNA 100% IA. Perguntas frequentes LGPD, implantação, formatos e mais. Veja a Dynadok em ação Reduza até 95% do tempo gasto com validação de documentos. Solicitar uma demonstração Indicador Número Ano Fonte Participação dos dados não estruturados nos dados gerados por empresas 90% 2025 IBM Crescimento dos dados não estruturados em relação aos estruturados 3 vezes 2025 IBM Mercado global de IDP USD 2,45 bilhões 2024 IMARC Group Projeção do mercado global de IDP USD 46,23 bilhões 2033 IMARC Group Extração em formulários (FUNSD) com modelo de texto e layout de 70,72 para 79,27 2020 Microsoft Research Extração em recibos (SROIE) com modelo de texto e layout de 94,02 para 95,24 2020 Microsoft Research Taxa de erro de caractere (CER) de LLM multimodal em manuscrito moderno (IAM) 1,71% 2025 Crosilla, Klic e Colavizza Assertividade declarada na validação de inscrições por IA (Vitru Educação) 90% 2025 Dynadok (depoimento) Fonte: elaboração própria com base em IBM (2025), IMARC Group (2025), Microsoft Research (2020), Crosilla, Klic e Colavizza (2025) e Dynadok (2026). A leitura da tabela: o volume a extrair é a maioria dos dados da empresa, e a tecnologia já opera com erro abaixo de 2% em manuscrito moderno e acima de 95 pontos em recibos. O que a legislação exige dos dados extraídos de documentos? A legislação brasileira exige que documentos digitalizados carreguem dados estruturados sobre si mesmos, e isso só é possível com extração. O Decreto nº 10.278, de 18 de março de 2020, art. 3º, inciso II, define metadados como “dados estruturados que permitem classificar, descrever e gerenciar documentos”, e no inciso I define documento digitalizado como o “representante digital do processo de digitalização do documento físico e seus metadados”. O art. 5º do Decreto nº 10.278/2020 determina que o documento digitalizado com efeitos legais perante o poder público deve ser assinado com certificado ICP-Brasil, seguir o Anexo I e conter, no mínimo, os metadados do",
"author": {
"@type": "Person",
"name": "Equipe Dynadok"
},
"image": "https://blog.dynadok.com/wp-content/uploads/2026/09/extracao.png"
}
]
}
```
# O que é extração de dados de documentos e como ela funciona
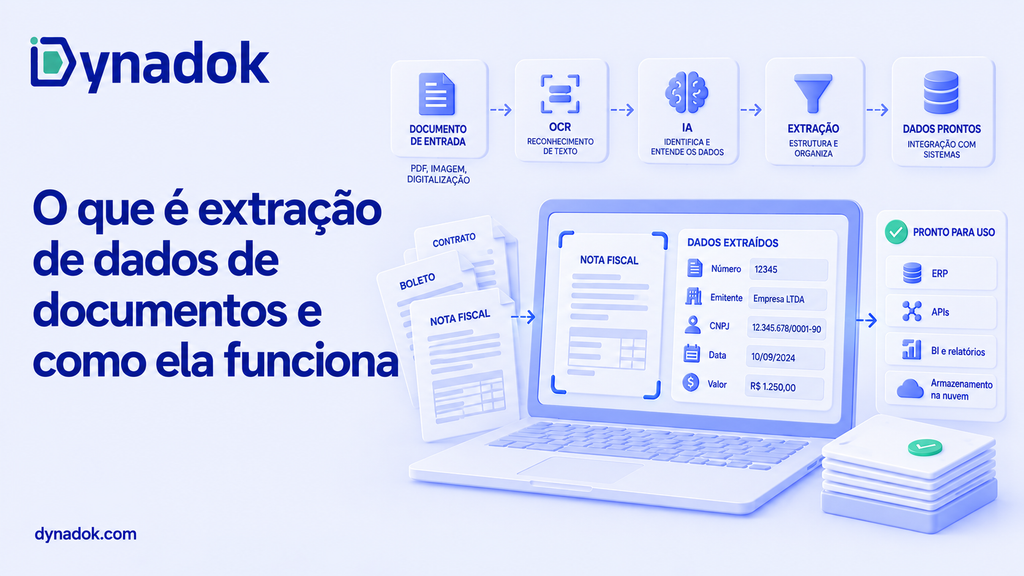Extração de dados de documentos é o processo que lê um arquivo (PDF, imagem, foto de celular ou XML), localiza os campos relevantes e os converte em dados estruturados prontos para validação, cruzamento e integração. Ela funciona em etapas: captura, classificação, reconhecimento de texto (OCR ou HTR), compreensão do layout, extração dos campos, validação por regras e entrega ao sistema. A IA faz esse ciclo em segundos, com revisão humana só nas exceções.
Resumir com IA [ ChatGPT ](#) [ Claude ](#) [ Perplexity ](#) [ Gemini ](#)
Prompt copiado! É só colar no Gemini.
## Pontos-chave
- Extração de dados é a leitura automática dos campos relevantes de um documento, “transformando imagens e PDFs em dados estruturados prontos para validação, cruzamento e integração”, segundo o glossário da Dynadok.
- OCR não é extração: o OCR converte imagem em texto; a extração identifica qual trecho é o CPF, a data ou o valor e o grava no campo certo, com score de confiança, segundo a documentação da Amazon Textract.
- Dados não estruturados representam 90% dos dados gerados pelas empresas e crescem a 3 vezes a taxa dos estruturados, segundo a IBM; é esse volume que a extração precisa converter.
- Modelos que aprendem texto e layout ao mesmo tempo elevaram a extração em formulários (FUNSD) de 70,72 para 79,27 pontos, segundo a Microsoft Research (KDD 2020).
- Em manuscrito moderno, LLMs multimodais atingem taxa de erro de caractere de 1,71% no benchmark IAM, segundo Crosilla, Klic e Colavizza (arXiv, 2025).
- O Decreto nº 10.278/2020 exige 8 metadados mínimos em todo documento digitalizado, e metadados são “dados estruturados que permitem classificar, descrever e gerenciar documentos”.
- Segundo a Dynadok, a extração combinada com validação reduz até 95% do tempo gasto com conferência de documentos.
## O que é extração de dados de documentos?
Extração de dados de documentos é a leitura automática dos campos relevantes de um documento (nome, CPF, datas, valores, cláusulas) e sua conversão em dados estruturados que um sistema consegue validar, cruzar e integrar. O glossário da Dynadok define a extração como a leitura que transforma “imagens e PDFs em dados estruturados prontos para validação, cruzamento e integração com outros sistemas”.
### Qual a diferença entre OCR e extração de dados?
OCR (reconhecimento óptico de caracteres) converte imagem de texto em texto editável e pesquisável; extração de dados identifica, dentro desse texto, qual trecho corresponde a cada campo. Segundo a Amazon Web Services, a Amazon Textract vai além do OCR simples para identificar, entender e extrair dados de formulários e tabelas, devolvendo campos, valores, relações entre eles e tabelas junto com scores de confiança.
Calculadora de ROI## Quanto a validação manual custa para a sua empresa hoje?
Ajuste 3 dados da sua operação e veja, na hora, quanto a conferência manual consome do seu caixa — e quanto volta para ele com a validação de documentos com IA.
[Calcular minha economia](https://blog.dynadok.com/calculadora/) Grátis · leva menos de 1 minuto
Exemplo de resultado −77% de custo
R$ 526.400/ano
de volta ao seu caixa — **R$ 43.867 por mês**
Operação manual hoje**R$ 56.667/mês**
Com a Dynadok**R$ 12.800/mês**
Cenário-exemplo: 20 mil páginas/mês, 5 min por página. Faça a conta com os números da sua operação.
Um exemplo torna a diferença concreta. O OCR aplicado a um ASO devolve um bloco de texto com nome, função, exames e a palavra “apto” em algum lugar. A extração devolve um registro: trabalhador, CPF, tipo de exame, data, médico responsável, resultado. Só o segundo formato permite verificar se o exame está no prazo e se o CPF confere com o RG anexado.
### O que sai da extração de dados?
O resultado da extração é um conjunto de pares campo e valor, cada um com um score de confiança e, nas plataformas maduras, com a posição de origem na página. Segundo a AWS, cada elemento detectado pela Amazon Textract vem acompanhado do score de confiança correspondente, o que permite encaminhar resultados de baixa confiança para revisão humana. O dado confiável segue sozinho; o duvidoso vai para uma pessoa.
## Por que a extração de dados de documentos importa para a operação?
A extração importa porque o volume de documentos sem estrutura cresce mais rápido do que qualquer equipe consegue digitar. Segundo a IBM, dados não estruturados representam 90% de todos os dados gerados pelas empresas e crescem a 3 vezes a taxa dos dados estruturados.
A demanda por dado estruturado cresce na mesma velocidade. Segundo Adam Wright, research manager da pesquisa Global DataSphere da IDC, “o equilíbrio entre dados estruturados e não estruturados está mudando”, e o crescimento mais rápido dos estruturados reflete a ênfase em sistemas que capturam, organizam e operacionalizam dados para automação e IA.
O mercado responde a essa pressão. Segundo a IMARC Group, o mercado global de processamento inteligente de documentos (IDP), categoria que tem a extração como núcleo, valia USD 2,45 bilhões em 2024 e deve chegar a USD 46,23 bilhões em 2033, com crescimento de 35,20% ao ano.
Continue explorando### Mais sobre a *Dynadok*
As páginas mais visitadas para você ver como transformamos documentos em decisões.
[ **Calculadora de ROI** Quanto a validação manual custa hoje? Grátis, 1 minuto. ](https://blog.dynadok.com/calculadora/) [ **Cases e depoimentos** Resultados reais de Cogna, Cenibra e Unicesumar. ](https://dynadok.com/cases-e-depoimentos-da-dynadok/) [ **API de validação** Integre ao seu sistema, ERP ou plataforma. ](https://dynadok.com/api-de-validacao-de-documentos/) [ **Preços e cobrança** Modelo simples, por páginas processadas. ](https://dynadok.com/precos-e-modelo-de-cobranca/) [ **Quem somos** Propósito, equipe e DNA 100% IA. ](https://dynadok.com/quem-somos-conheca-nosso-proposito-equipe-e-valores/) [ **Perguntas frequentes** LGPD, implantação, formatos e mais. ](https://dynadok.com/perguntas-e-respostas-sobre-a-dynadok/)
Veja a Dynadok em ação Reduza até 95% do tempo gasto com validação de documentos.
[Solicitar uma demonstração](https://dynadok.com/)
IndicadorNúmeroAnoFonteParticipação dos dados não estruturados nos dados gerados por empresas90%2025IBMCrescimento dos dados não estruturados em relação aos estruturados3 vezes2025IBMMercado global de IDPUSD 2,45 bilhões2024IMARC GroupProjeção do mercado global de IDPUSD 46,23 bilhões2033IMARC GroupExtração em formulários (FUNSD) com modelo de texto e layoutde 70,72 para 79,272020Microsoft ResearchExtração em recibos (SROIE) com modelo de texto e layoutde 94,02 para 95,242020Microsoft ResearchTaxa de erro de caractere (CER) de LLM multimodal em manuscrito moderno (IAM)1,71%2025Crosilla, Klic e ColavizzaAssertividade declarada na validação de inscrições por IA (Vitru Educação)90%2025Dynadok (depoimento)Fonte: elaboração própria com base em IBM (2025), IMARC Group (2025), Microsoft Research (2020), Crosilla, Klic e Colavizza (2025) e Dynadok (2026).
A leitura da tabela: o volume a extrair é a maioria dos dados da empresa, e a tecnologia já opera com erro abaixo de 2% em manuscrito moderno e acima de 95 pontos em recibos.
## O que a legislação exige dos dados extraídos de documentos?
A legislação brasileira exige que documentos digitalizados carreguem dados estruturados sobre si mesmos, e isso só é possível com extração. O Decreto nº 10.278, de 18 de março de 2020, art. 3º, inciso II, define metadados como “dados estruturados que permitem classificar, descrever e gerenciar documentos”, e no inciso I define documento digitalizado como o “representante digital do processo de digitalização do documento físico e seus metadados”.
O art. 5º do Decreto nº 10.278/2020 determina que o documento digitalizado com efeitos legais perante o poder público deve ser assinado com certificado ICP-Brasil, seguir o Anexo I e conter, no mínimo, os metadados do Anexo II. O Anexo I fixa 300 dpi e formato PDF/A para textos impressos e manuscritos. O Anexo II exige 8 metadados: assunto, autor, data e local da digitalização, identificador do documento digital, responsável pela digitalização, título, tipo documental e hash da imagem. Autor, título e tipo documental são campos extraídos do conteúdo.
Duas outras referências sustentam a exigência. A Lei nº 8.159, de 8 de janeiro de 1991, art. 3º, define gestão de documentos como “o conjunto de procedimentos e operações técnicas referentes à sua produção, tramitação, uso, avaliação e arquivamento”. No plano internacional, o Dublin Core é um vocabulário de quinze elementos de descrição (título, autor, assunto, data, tipo, identificador), padronizado em 1998 e publicado como ISO 15836, segundo a DCMI. Já a NF-e mostra o extremo oposto: segundo a SEF/MG, a nota é um documento de existência digital em XML, e por isso o destinatário elimina a digitação na recepção de mercadorias.
Norma ou padrãoO que exige em relação aos dados extraídosQuem respondeReferênciaDecreto nº 10.278/2020, art. 3ºMetadados são dados estruturados que classificam, descrevem e gerenciam documentosQuem digitalizaArt. 3º, I e IIDecreto nº 10.278/2020, Anexo II8 metadados mínimos, incluindo autor, título e tipo documental, extraídos do conteúdoQuem digitalizaAnexo II, item aDecreto nº 10.278/2020, Anexo I300 dpi e PDF/A para textos; 600 dpi para plantas e mapasQuem digitalizaAnexo IDecreto nº 10.278/2020, art. 4ºIntegridade, rastreabilidade, auditabilidade e interoperabilidade do processoQuem digitalizaArt. 4ºLei nº 8.159/1991, art. 3ºGestão de documentos em todas as fases, da produção ao arquivamentoPoder público e arquivos privadosArt. 3º e art. 11Ajuste SINIEF 07/2005 (NF-e)Documento fiscal nato-digital em XML, sem necessidade de extração por imagemEmitente e destinatárioSEF/MGDublin Core (ISO 15836)Quinze elementos de descrição do recursoQuem descreve o recursoDCMI, versão 1.1Fonte: Brasil (Decreto nº 10.278/2020 e Lei nº 8.159/1991), SEF/MG e DCMI.
O ponto prático: a lei não diz “use IA”, mas exige resultados (metadados completos, integridade, rastreabilidade) que só uma extração sistemática entrega em volume.
## Como a extração de dados é feita hoje e onde ela falha?
Hoje a extração ainda é, na maioria das operações, uma pessoa lendo a tela e digitando em outra. A Dynadok resume o efeito na própria home: o processo manual não escala, é caro, é lento e gera erros. Segundo Karla Lemos, Gerente de CSC da Unicesumar, em depoimento no site da Dynadok, a análise de documentos do Prouni chegava a envolver 25 pessoas antes da IA.
Quando a empresa tenta automatizar com ferramentas de primeira geração, os gargalos mudam de forma, mas não desaparecem:
- O OCR devolve texto sem campos: a equipe recebe um bloco de texto corrido e continua tendo que localizar o CPF, a data e o valor à mão.
- Templates por layout quebram a cada variação: a extração por coordenadas funciona para um modelo de comprovante e falha no modelo da concessionária vizinha.
- Campos manuscritos ficam de fora: carimbos, assinaturas e anotações à mão não são lidos pelo OCR clássico e voltam para a fila humana.
- Não há score de confiança: sem uma medida de certeza por campo, ou tudo vai para revisão ou nada vai, e o erro raro passa despercebido.
- O dado extraído não é validado: um CPF com dígito verificador inválido ou uma data impossível entra no sistema como se fosse correto.
- Os metadados exigidos pelo Decreto nº 10.278/2020 ficam vazios, porque ninguém preenche tipo documental, autor e hash de cada arquivo.
A raiz é a mesma: a ferramenta lê, mas não entende.
## Como funciona a extração de dados de documentos passo a passo?
A extração de dados funciona como um pipeline de oito etapas, em que o reconhecimento de texto é só uma delas. A Dynadok combina OCR, visão computacional, LLMs e RAG para executar esse fluxo em produção; a sequência abaixo vale para qualquer operação.
1. Capture o documento com qualidade mínima. Oriente quem envia a fotografar o documento inteiro, com boa iluminação; o Anexo I do Decreto nº 10.278/2020 fixa 300 dpi para textos.
2. Pré-processe a imagem. A visão computacional corrige rotação, contraste, sombras e ruído.
3. Classifique o documento pelo conteúdo. A IA identifica se o arquivo é um RG, uma CND, um ASO ou um contrato social, independentemente do nome do arquivo, e o encaminha para o esquema de campos correto. Esse esquema nasce da [taxonomia documental da organização](https://blog.dynadok.com/ia/o-que-e-taxonomia-documental-e-como-organizar-seus-arquivos/).
4. Reconheça o texto com a tecnologia certa. Texto impresso pede OCR; campos manuscritos pedem HTR ou LLM multimodal, que atingem CER de 1,71% em manuscrito moderno segundo Crosilla, Klic e Colavizza.
5. Interprete o layout junto com o texto. Modelos como o LayoutLM, da Microsoft Research, aprendem a posição 2D de cada palavra na página junto com o texto, o que elevou a extração em formulários (FUNSD) de 70,72 para 79,27 pontos. É o que permite distinguir a data de validade da data de emissão.
6. Extraia os campos definidos no esquema. Cada campo recebe um valor e um score de confiança; segundo a AWS, a Amazon Textract permite inclusive perguntar em linguagem natural qual dado se quer, sem depender da estrutura ou das variações de layout do documento.
7. Valide e cruze os dados. Dígito verificador de CPF e CNPJ, datas possíveis, validade vencida, campos obrigatórios presentes; depois, o CPF da ficha é comparado com o do RG e o CNPJ do contrato social com o da CND. Na Dynadok, essa etapa usa checklists personalizados e cruzamento entre documentos.
8. Entregue ao sistema e roteie exceções. O dado validado segue por API para o ERP, o GED ou o CRM; leituras com score baixo ou divergência de cruzamento vão para revisão humana. O percentual de documentos que atravessa o pipeline sem intervenção é a taxa de automação, o principal indicador de maturidade.
Executado em ordem, o pipeline transforma um PDF ou uma foto em um registro estruturado, validado e auditável.
## Como escolher a tecnologia de extração de dados de documentos?
A escolha depende de quatro perguntas: quais formatos entram, se há manuscrito, quanto os layouts variam e o que acontece com o dado depois de extraído. Um XML de NF-e não precisa de extração por imagem; fotos, PDFs escaneados e formulários variados exigem interpretação, e é aí que as abordagens se separam.
CritérioTemplates e expressões regularesOCR clássicoIDP com modelos de layoutIA generativa com validação (Dynadok)O que lêCampos em posição fixaTexto impressoTexto e posição dos camposTexto, layout, contexto e manuscritoNovo layoutNovo templateSem impacto na leitura, mas sem camposRetreino ou ajuste do modeloSem mapeamento prévioManuscritoNão lêNão lêParcialLê com HTR e LLM multimodal (CER de 1,71% no IAM)Score de confiança por campoNãoNãoSimSim, com roteamento para revisão humanaValidação por regrasFora da ferramentaFora da ferramentaRegras fixasChecklists personalizados por tipo de documentoCruzamento entre documentosNãoNãoLimitadoSim, entre documentos e com sistemas via APIEscalaBaixaMédia, com conferência posteriorMédia a altaAlta, com revisão só nas exceçõesFonte: elaboração própria com base em AWS, Microsoft Research (2020), Crosilla, Klic e Colavizza (2025) e Dynadok (2026).
O critério decisivo é o que vem depois da leitura. Como resume Cássio Lapertosa, Diretor de TI da Emccamp, sobre a IA da Dynadok: a tecnologia “não só lê campos, mas interpreta documentos cruzando informações”. Ao comparar fornecedores, teste com um dossiê real e conte quantos campos saem extraídos, validados e cruzados sem intervenção.
## Quais erros mais comuns na extração de dados de documentos?
Os erros mais comuns nascem de parar na leitura ou de confiar nela sem contraprova. Cada erro abaixo tem uma consequência mensurável na operação:
- Confundir OCR com extração: comprar uma ferramenta de OCR esperando campos estruturados e descobrir que a equipe continua digitando a partir do texto corrido.
- Mapear templates por layout: cada fornecedor, clínica ou concessionária que muda o modelo quebra a extração e cria uma fila de exceções não prevista.
- Ignorar o manuscrito: campos preenchidos à mão viram o trabalho residual da equipe, embora a tecnologia já leia manuscrito moderno com CER de 1,71%, segundo Crosilla, Klic e Colavizza.
- Aceitar dado sem score de confiança: sem uma medida por campo, o erro raro não é roteado para revisão e entra no sistema em silêncio.
- Não validar nem cruzar: um “7” lido como “1” no CPF só é pego quando o dado é comparado com o RG anexado; sem cruzamento, o erro de leitura vira erro cadastral.
- Descartar a posição de origem: sem saber de qual trecho da página veio cada valor, a auditoria exigida pelo art. 4º do Decreto nº 10.278/2020 fica impossível.
- Extrair mais do que o processo precisa: coletar campos sem finalidade aumenta o risco com dados pessoais e contraria o princípio de minimização que a Dynadok declara seguir na LGPD.
Evitar esses erros exige desenhar a extração como parte de uma esteira, com validação, cruzamento e revisão por exceção.
## Como a Dynadok faz a extração de dados de documentos?
A Dynadok é uma plataforma brasileira de validação automática de documentos com IA que identifica e extrai informações de documentos com dados estruturados, semiestruturados, não estruturados e escritos à mão, em imagens ou PDFs, inclusive arquivos digitalizados com centenas de páginas. A tecnologia une LLMs, OCR, visão computacional e RAG, e o dado extraído passa por checklists personalizados e cruzamento entre documentos antes de chegar ao sistema do cliente via API.
Segundo a Dynadok, a extração combinada com validação reduz até 95% do tempo gasto com conferência e torna as validações até 10 vezes mais rápidas. No cenário-exemplo da calculadora de ROI, com 20 mil páginas por mês a 5 minutos por página, a operação manual custa R$ 56.667 por mês contra R$ 12.800 com a plataforma, economia de 77% ou R$ 526.400 por ano, segundo a empresa.
Os clientes confirmam o resultado. Segundo Chrystiano Mincoff, Diretor Executivo de Experiência e Permanência da Vitru Educação, “chegamos a uma assertividade de 90%”, com 9 em cada 10 inscrições validadas pela IA. Na Unicesumar, Karla Lemos, Gerente de CSC, relata que a operação do Prouni passou de até 25 pessoas para 10. Para campos preenchidos à mão, a plataforma aplica a mesma esteira, como detalha o artigo sobre [leitura de documentos manuscritos por IA](https://blog.dynadok.com/ia/ia-le-documento-manuscrito-entenda-o-que-a-tecnologia-ja-consegue-fazer/). Os termos técnicos deste guia estão no [glossário de validação e automação de documentos](https://dynadok.com/glossario-de-validacao-e-automacao-de-documentos/) da Dynadok.
## Perguntas frequentes sobre extração de dados de documentos
### O que é extração de dados de documentos em uma frase?
Extração de dados de documentos é a leitura automática dos campos relevantes de um documento (nome, CPF, datas, valores) e sua conversão em dados estruturados prontos para validação, cruzamento e integração, segundo o glossário da Dynadok. A entrada pode ser PDF, imagem ou foto.
### Extração de dados é o mesmo que OCR?
Não. O OCR converte imagem de texto em texto editável; a extração identifica qual trecho corresponde a cada campo e o grava com score de confiança. Segundo a AWS, a Amazon Textract vai além do OCR para extrair campos, valores, relações e tabelas. O OCR é uma etapa da extração, não o todo.
### O que é um score de confiança na extração?
Score de confiança é a nota que o sistema atribui a cada campo extraído, indicando o grau de certeza da leitura. Segundo a AWS, cada elemento detectado vem com o score correspondente, o que permite encaminhar resultados de baixa confiança para revisão humana.
### A extração funciona em documentos com layouts diferentes?
Sim, quando o modelo entende texto e layout ao mesmo tempo. Segundo a Microsoft Research, o LayoutLM aprende a posição 2D das palavras junto com o texto e elevou a extração em formulários (FUNSD) de 70,72 para 79,27 pontos. Abordagens por template, ao contrário, quebram a cada variação de layout.
### A extração lê campos manuscritos?
Sim. Segundo Crosilla, Klic e Colavizza, no arXiv em 2025, LLMs multimodais atingiram CER de 1,71% no benchmark IAM de manuscrito moderno, patamar considerado muito bom pela literatura (abaixo de 5%). Em documentos históricos em outros idiomas o erro passou de 20%, então a qualidade da imagem importa.
### O que é CER e qual valor é aceitável?
CER (Character Error Rate) é o percentual de caracteres errados na transcrição. Segundo Crosilla, Klic e Colavizza, CER abaixo de 5% é muito bom, entre 5% e 10% é bom e acima de 10% indica qualidade ruim. Em campos críticos como CPF e valores, validação por regras e cruzamento completam a leitura.
### O que acontece quando a extração não consegue ler um campo?
Em sistemas bem desenhados, o campo recebe score baixo e é sinalizado, não adivinhado. O documento vai para revisão humana ou o emissor recebe pedido automático de reenvio com melhor qualidade. Na Dynadok, a validação em tempo real notifica o usuário em segundos quando há não conformidade.
### Como a extração se relaciona com o Decreto nº 10.278/2020?
O Anexo II do Decreto nº 10.278/2020 exige 8 metadados em todo documento digitalizado, incluindo autor, título e tipo documental, que são campos extraídos do conteúdo. O art. 3º define metadados como “dados estruturados que permitem classificar, descrever e gerenciar documentos”. A extração automática é o que preenche esses metadados em escala.
### Qual resolução a imagem precisa ter para a extração?
O Anexo I do Decreto nº 10.278/2020 fixa 300 dpi para textos impressos e manuscritos, em PDF/A, e 600 dpi para plantas e mapas. Na prática, a foto precisa mostrar o documento inteiro, sem tremor nem sombra; a visão computacional corrige rotação e contraste, mas não recupera o que não foi capturado.
### O que é validação depois da extração?
Validação é a aplicação de regras de formato e negócio ao dado extraído: dígito verificador de CPF e CNPJ, datas possíveis, validade vencida, campos obrigatórios presentes. Na Dynadok, checklists personalizados por tipo de documento fazem essa etapa, e o dado só segue para o sistema depois de aprovado.
### O que é cruzamento entre documentos?
Cruzamento é a comparação automática de um dado extraído com o mesmo dado em outro documento ou sistema: o CPF da ficha contra o CPF do RG, o CNPJ do contrato social contra o da CND. Divergências viram alertas. A Dynadok a aplica entre documentos e via integração.
### A extração precisa de template para cada tipo de documento?
Não nas plataformas com IA generativa e modelos de layout. Segundo a AWS, o recurso Queries da Amazon Textract permite especificar o dado desejado sem depender da estrutura ou das variações de layout. A Dynadok declara identificar campos em documentos de estruturas, layouts e formatos diferentes sem mapeamento prévio.
### Quais documentos a Dynadok extrai e valida?
Documentos de identificação (RG, CNH, CPF, passaporte), societários (contrato social, CNPJ), de SST (PGR, PCMSO, ASO), certidões negativas, notas fiscais, comprovantes de endereço, documentos educacionais (Prouni, FIES, matrícula) e trabalhistas (eSocial, DCTFWeb), segundo a lista publicada na home da Dynadok, em imagens ou PDFs.
### Como a extração se integra ao meu sistema?
Por API. Segundo a Dynadok, a plataforma se adapta ao ambiente atual e entrega os dados extraídos e validados ao ERP, GED ou CRM que a empresa já usa, sem troca de sistema. A implantação leva de 1 a 4 meses conforme regras de negócio, tipos de documento e integrações, segundo a empresa.
### Quanto custa extrair dados manualmente?
No cenário-exemplo da calculadora de ROI da Dynadok, com 20 mil páginas por mês a 5 minutos por página, a operação manual custa R$ 56.667 por mês, contra R$ 12.800 com a plataforma: economia de 77%, ou R$ 526.400 por ano, segundo a Dynadok. A cobrança é feita por página processada pela IA.
### A IA de extração substitui a conferência humana?
Substitui o volume, não o julgamento. No modelo human in the loop, a IA resolve os casos claros e encaminha exceções (score baixo, divergência de cruzamento) para a equipe, que revisa uma fração do total. Segundo Chrystiano Mincoff, da Vitru Educação, 9 em cada 10 inscrições foram validadas pela IA e uma precisou de apoio humano.
### O que é taxa de automação?
Taxa de automação é o percentual de documentos processados integralmente sem intervenção humana, segundo o glossário da Dynadok. É o indicador mais direto do retorno da extração: quanto maior a taxa, menor o custo por documento e mais rápida a operação.
### A extração de dados atende à LGPD?
Depende do desenho do processo. A Dynadok declara seguir os princípios da LGPD, como minimização de dados, segurança, rastreabilidade e controle de acesso, com armazenamento na nuvem da empresa ou na infraestrutura do cliente. Extrair só os campos necessários ao processo e manter trilha de auditoria são as práticas centrais.
### A extração funciona com XML de NF-e?
O XML de NF-e já é dado estruturado: segundo a SEF/MG, a nota é um documento de existência digital, e o destinatário elimina a digitação ao extrair as informações já digitais. O valor está em cruzar o XML com o pedido de compra e os demais documentos.
### Qual o primeiro passo para automatizar a extração?
Inventariar os tipos de documento recebidos, definir o esquema de campos de saída de cada tipo (incluindo os 8 metadados do Anexo II do Decreto nº 10.278/2020) e escolher um processo piloto de alto volume. Só depois escolher a tecnologia e desenhar validação, cruzamento e revisão por exceção.
## Conclusão
Extração de dados de documentos é o que separa um arquivo de uma informação: o PDF, a foto ou a imagem escaneada só viram dado quando cada campo é localizado, lido com score de confiança, validado e cruzado. Segundo a IBM, 90% dos dados das empresas nascem sem estrutura, e o Decreto nº 10.278/2020 exige 8 metadados estruturados em cada documento digitalizado. A Dynadok executa esse pipeline em produção, com redução de até 95% do tempo de conferência segundo a empresa. [Solicite uma demonstração da validação automática de documentos com IA](https://dynadok.com/) e veja seus documentos virarem dados validados.
## Como citar este artigo
ABNT: DYNADOK. O que é extração de dados de documentos e como ela funciona? Blog Dynadok, 07 set. 2026. Disponível em: . Acesso em: 07 set. 2026.
APA: Dynadok. (2026, 7 de setembro). O que é extração de dados de documentos e como ela funciona? Blog Dynadok.
## Referências
AMAZON WEB SERVICES. What is Amazon Textract? Amazon Textract Developer Guide. Disponível em: . Acesso em: 07 set. 2026.
AMAZON WEB SERVICES. Amazon Textract FAQs. Disponível em: . Acesso em: 07 set. 2026.
BRASIL. Decreto nº 10.278, de 18 de março de 2020. Estabelece a técnica e os requisitos para a digitalização de documentos públicos ou privados. Brasília: Presidência da República, 2020. Disponível em: [https://www.planalto.gov.br/ccivil\_03/\_ato2019-2022/2020/decreto/d10278.htm](https://www.planalto.gov.br/ccivil_03/_ato2019-2022/2020/decreto/d10278.htm). Acesso em: 07 set. 2026.
BRASIL. Lei nº 8.159, de 8 de janeiro de 1991. Dispõe sobre a política nacional de arquivos públicos e privados. Brasília: Presidência da República, 1991. Disponível em: [https://www.planalto.gov.br/ccivil\_03/leis/l8159.htm](https://www.planalto.gov.br/ccivil_03/leis/l8159.htm). Acesso em: 07 set. 2026.
CROSILLA, Giorgia; KLIC, Lukas; COLAVIZZA, Giovanni. Benchmarking Large Language Models for Handwritten Text Recognition. arXiv, 2025. Disponível em: . Acesso em: 07 set. 2026.
DUBLIN CORE METADATA INITIATIVE. Dublin Core Metadata Element Set, Version 1.1: Reference Description. DCMI, 2012. Disponível em: . Acesso em: 07 set. 2026.
DYNADOK. Glossário de Validação e Automação de Documentos. Dynadok, 2026. Disponível em: . Acesso em: 07 set. 2026.
DYNADOK. IA lê documento manuscrito? Entenda o que a tecnologia já consegue fazer. Blog Dynadok, 2026. Disponível em: . Acesso em: 07 set. 2026.
DYNADOK. O que é taxonomia documental e como organizar seus arquivos. Blog Dynadok, 2026. Disponível em: . Acesso em: 07 set. 2026.
DYNADOK. Validação automática de documentos com IA. Dynadok, 2026. Disponível em: . Acesso em: 07 set. 2026.
IBM. Structured vs. unstructured data: What’s the difference? IBM Think, 2025. Disponível em: . Acesso em: 07 set. 2026.
IDC. Worldwide Global DataSphere Structured and Unstructured Data Forecast, 2025-2029. IDC, 2025. Disponível em: [https://my.idc.com/getdoc.jsp?containerId=US52800025&pageType=PRINTFRIENDLY](https://my.idc.com/getdoc.jsp?containerId=US52800025&pageType=PRINTFRIENDLY). Acesso em: 07 set. 2026.
IMARC GROUP. Intelligent Document Processing Market Size, Share, Trends and Forecast, 2025-2033. IMARC, 2025. Disponível em: . Acesso em: 07 set. 2026.
MINAS GERAIS. Secretaria de Estado de Fazenda. Nota Fiscal Eletrônica: perguntas frequentes. Portal SPED MG. Disponível em: [https://portalsped.fazenda.mg.gov.br/spedmg/nfe/Perguntas-Frequentes/respostas\_i/index.html](https://portalsped.fazenda.mg.gov.br/spedmg/nfe/Perguntas-Frequentes/respostas_i/index.html). Acesso em: 07 set. 2026.
XU, Yiheng et al. LayoutLM: Pre-training of Text and Layout for Document Image Understanding. KDD 2020. Microsoft Research, 2020. Disponível em: . Acesso em: 07 set. 2026.
Calculadora de ROI da Validação Documental com IA | Dynadok Calculadora Dynadok## Calculadora de ROI da Validação Documental com IA
Use a calculadora de ROI da Dynadok: ajuste 3 dados da sua operação e veja, na hora, quanto a conferência manual custa hoje — e quanto volta ao seu caixa com a validação documental com IA.
## Dados da operação
Esses 3 dados descrevem como funciona a sua conferência de documentos hoje — é com eles que calculamos o custo atual da operação e a economia ao automatizar com IA. Não precisa ser exato: uma boa estimativa já gera um resultado confiável.
Quantas páginas de documentos sua equipe confere por mês?
20.000
5 mil100 mil
Considere o volume mensal de páginas que sua equipe precisa receber, organizar, conferir, validar e atualizar nos sistemas. Não sabe o total? Estime: documentos recebidos no mês × média de páginas por documento.
Processa **100 mil páginas ou mais** por mês? [Converse com um especialista](https://dynadok.com/) para um plano sob medida.
Quanto tempo leva para conferir 1 página?
5 min
1 min10 min
Inclua o ciclo completo: abrir o documento, extrair dados, conferir regras, registrar o resultado e devolver pendências. Estudos de mercado apontam de 3 a 10 minutos por página — se nunca mediu, mantenha os 5 min, uma média conservadora.
Quanto ganha quem faz essa conferência?
R$ 3.500
R$ 1.500R$ 15.000
Digite apenas o salário mensal de quem confere esses documentos hoje (ex.: analista, assistente administrativo), sem encargos. A calculadora acrescenta sozinha os encargos e benefícios, multiplicando por 1,7 — aproximadamente o custo real de um funcionário para a empresa.
Calcular minha economiaO resultado é gerado depois do cálculo e atualizado sempre que você mudar os dados.
Você mudou os dados. Clique em **Recalcular** para atualizar o resultado.
## O resultado da sua calculadora de ROI aparece aqui
Ajuste os dados da operação e clique em **“Calcular minha economia”** para ver uma prévia feita com os números do seu cenário.
**1.** Informe os dados **2.** Calcule a prévia **3.** Libere o resultado
Prévia da sua operaçãoIdentificamos
alto potencial de economia
77%
mais barato por mês que a operação manual
Estimativa de **R$ 526.400** de volta ao seu caixa por ano
Resultado completo**Economia mensal detalhada**
Resultado completo**Comparativo de custos**
Resultado completo**Impacto operacional**
### Libere o resultado completo
Preencha seus dados para ver a economia mensal em reais, o comparativo de custos e as horas liberadas na sua equipe.
Seu nome
Telefone
E-mail corporativo
Empresa
Sua necessidade (opcional)
Ver meu resultado completo Seus dados ficam seguros. Um especialista da Dynadok pode entrar em contato para ajudar na sua análise.
Sua economiaEconomia anual estimada
R$ 526.400
Equivale a **R$ 43.867** por mês
Estimativa conservadora
ROI estimado (mensal)
343%
A cada R$ 1 investido no plano, cerca de R$ 4,43 deixam de ser gastos na operação manual.
Redução do custo operacional
77%
Você deixa de gastar cerca de 8 de cada 10 reais que o trabalho mecânico de conferência consome hoje.
### Sua operação manual ESTIMADA hoje
Profissionais
10
profissionais dedicados ao trabalho mecânico de conferência (~80% do esforço)
Custo manual
R$ 56.667
custo mensal com esses profissionais (salário + provisão)
Horas gastas
1.333 h
horas gastas por mês em conferência manual mecânica
Como chegamos nesse número Com um tempo médio de 5 minutos por página, um profissional valida cerca de 12 páginas por hora. Em uma jornada de 7 horas, são 84 páginas por dia — e, em 20 dias úteis, cerca de 1.680 páginas por mês. Como sua operação processa 20.000 páginas por mês, o volume equivale ao trabalho de aproximadamente 12 profissionais. Nesta avaliação, consideramos que cerca de 80% desse esforço é trabalho operacional mecânico — o equivalente a 10 profissionais e 1.333 horas por mês. São esses números que usamos em todo o resultado.
Com a Dynadok, todo o trabalho operacional — mecânico, repetitivo e manual — passa a ser feito pela IA. Isso libera cerca de 80% do time para outras frentes; os demais deixam a conferência página a página e passam a atuar apenas na validação final e no tratamento de exceções.
### Comparativo de custos
Operação manual hoje
Custo mensal do trabalho mecânico
R$ 56.667
Operação com a Dynadok
Plano por páginas processadas
R$ 12.800
Economia mensal
Valor que permanece no caixa
R$ 43.867
### O que você libera com a Dynadok
Horas liberadas
1.333 h
horas de trabalho manual liberadas por mês (cerca de 80% do esforço atual)
Time liberado
10
profissionais liberados para outras frentes — os demais atuam só na validação final e em exceções
### Ganhos além da economia
A redução de custo é só uma parte. Validar documentos com a IA da Dynadok também transforma a operação:
**Validações até *10x mais rápidas***O que hoje leva horas passa a ser feito em minutos ou segundos, acelerando a resposta ao seu cliente.
**Mais precisão, *menos falhas humanas***Regras claras e validações automatizadas reduzem erros em tarefas repetitivas e não conformidades.
**Processamento *em escala***Valide grandes volumes, em qualquer formato ou layout, sem aumentar o time na mesma proporção.
**Time focado *no estratégico***Sua equipe sai das tarefas manuais e passa a cuidar de análises e decisões que fazem o negócio crescer.
Estimativa ilustrativa da calculadora de ROI. Jornada de 7 h/dia em 20 dias úteis (140 h/mês) por profissional e fator de provisão de 1,7 sobre o salário base. A economia compara o custo da mão de obra dedicada ao trabalho mecânico de conferência (cerca de 80% do esforço total; os demais profissionais seguem na validação final e em exceções) com o custo do plano Dynadok para o mesmo volume de páginas.
Estimativa conservadora da calculadora de ROI da validação documental com IA, baseada nas premissas de operação: ciclo completo de validação documental por página, jornada de 7 h/dia em 20 dias úteis (140 h/mês) por profissional e fator de provisão de 1,7 sobre o salário base (encargos e benefícios). A economia compara o custo da mão de obra dedicada ao trabalho mecânico de conferência — cerca de 80% do esforço total, já que os demais profissionais seguem atuando na validação final e no tratamento de exceções — com o custo do plano Dynadok para o mesmo volume de páginas. Os valores variam conforme volume e complexidade — solicite uma análise personalizada para números exatos da sua operação.
Compartilhe Gostou deste artigo?
Envie para quem também vai aproveitar este conteúdo.
[ ](#) [ ](#) [ ](#) [ ](#) [ ](#) [ ](#)